데이터에도 모양이 있다: TDA로 연결, 분기, 구멍을 읽는 법
고차원 점군이 겹치는 렌즈 구간을 지나 Mapper 네트워크로 압축되는 모습
**Topological Data Analysis(TDA)**는 데이터를 점들의 목록으로만 보지 않고, 점들이 함께 만드는 연결·분기·순환·구멍을 읽는 방법이다. 이 글에서는 직관에서 출발해 Mapper와 persistent homology를 이해하고, Differentiable Mapper와 Topological Deep Learning까지 경계를 넓혀 본다.
Topological Data Analysis · Mapper · Persistent Homology · Soft Mapper · Topological Deep Learning
왜 데이터의 ’모양’을 봐야 할까?
고차원 데이터를 이해할 때 가장 먼저 떠올리는 두 도구는 차원 축소와 군집화다.
-
차원 축소는 변수를 줄여 데이터를 화면에 펼친다.
-
군집화는 많은 표본을 몇 개 그룹으로 요약한다.
둘 다 강력하지만 질문이 하나 남는다. 같은 하나의 군집 안에서 점들이 고리를 이루는가, 한 상태에서 두 방향으로 갈라지는가, 아니면 작은 하위 집단이 긴 꼬리처럼 뻗는가? 군집의 개수만으로는 이 차이를 표현하기 어렵다.
순환, 분기, 플레어 모양의 점군 비교
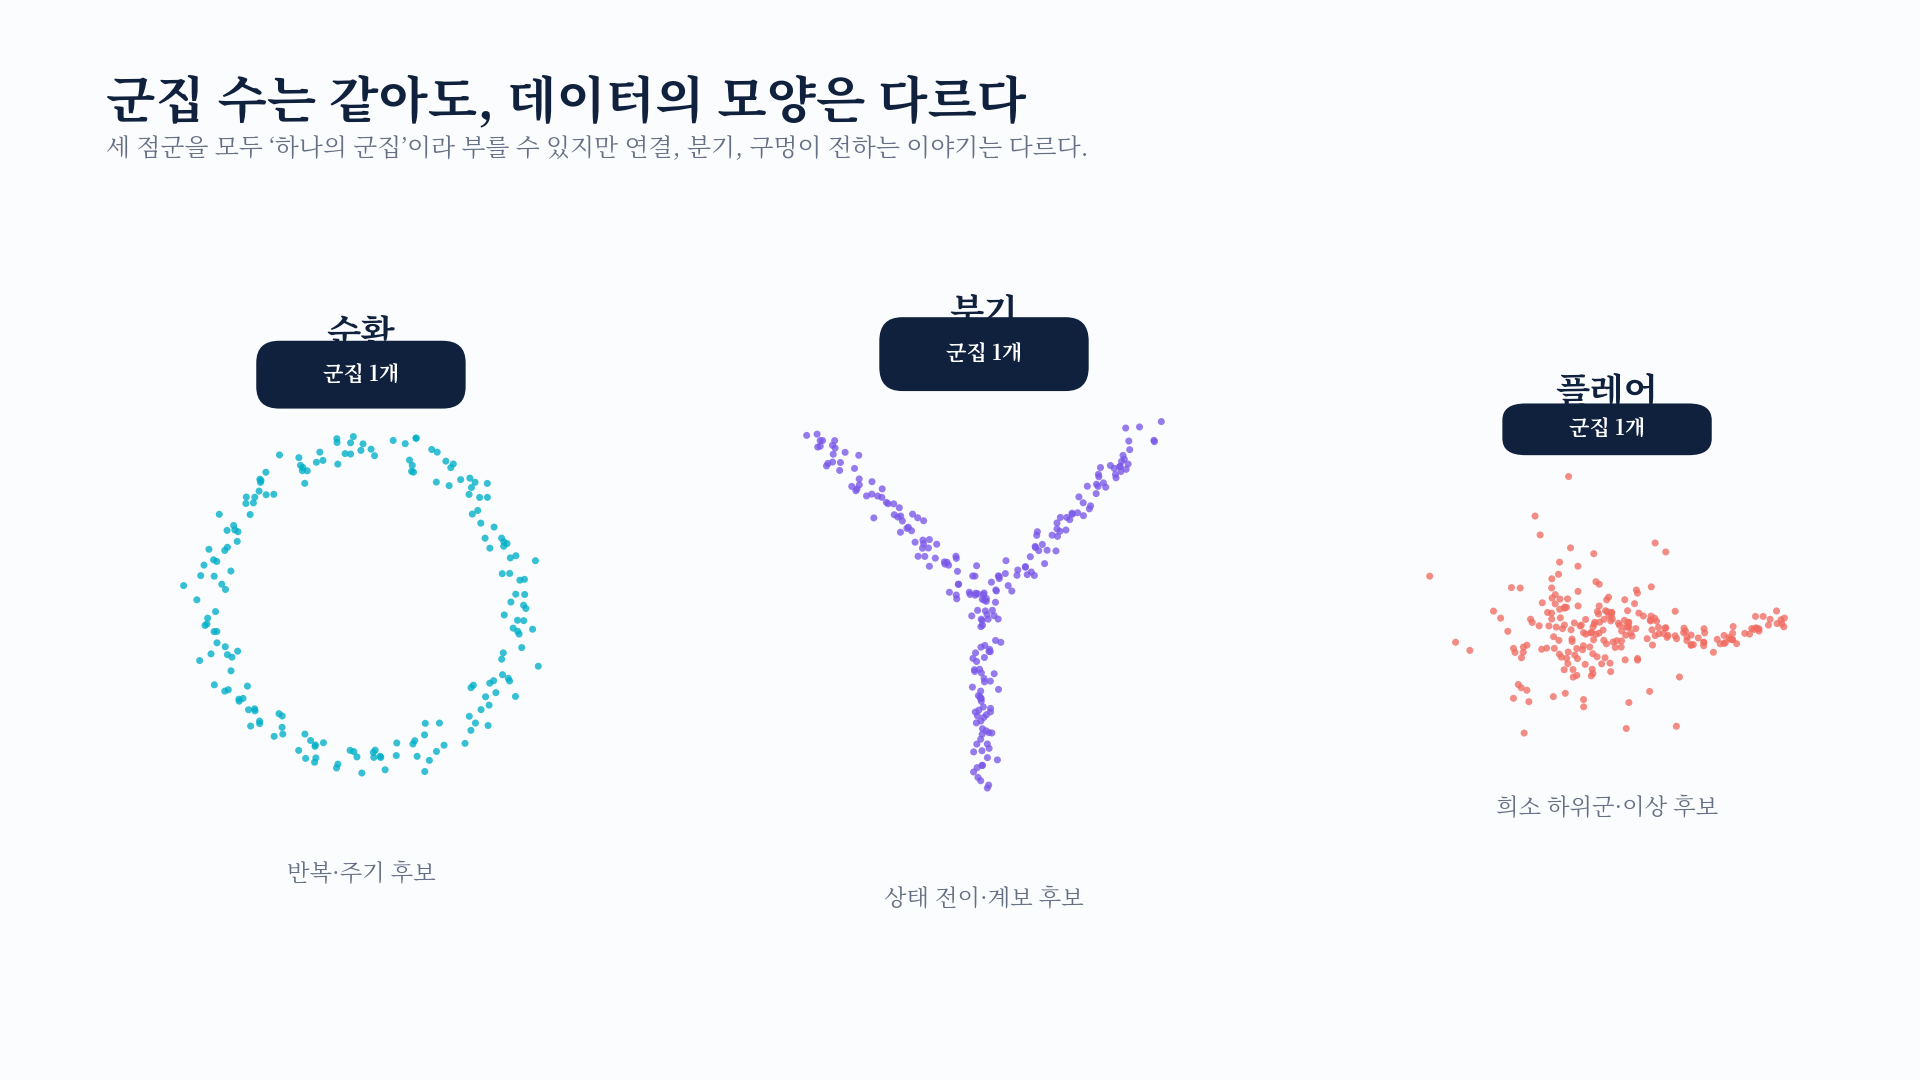
세 점군은 모두 하나의 군집으로 묶일 수 있지만, 순환·분기·플레어라는 서로 다른 가설을 제안한다.
2013년 Lum과 동료들은 이런 관점을 “복잡한 데이터의 모양에서 통찰을 추출한다”고 설명했다. 논문은 유방암 유전자 발현, 미국 하원 표결, NBA 선수 성과라는 전혀 다른 데이터에 같은 위상적 분석 파이프라인을 적용했다. 핵심은 TDA가 답을 자동으로 확정한다는 뜻이 아니다. 후속 통계 검정과 도메인 분석이 필요한 하위 집단과 구조를 발견하는 탐색 지도를 만든다는 뜻이다.
1. 위상수학의 렌즈: 길이보다 연결과 구멍
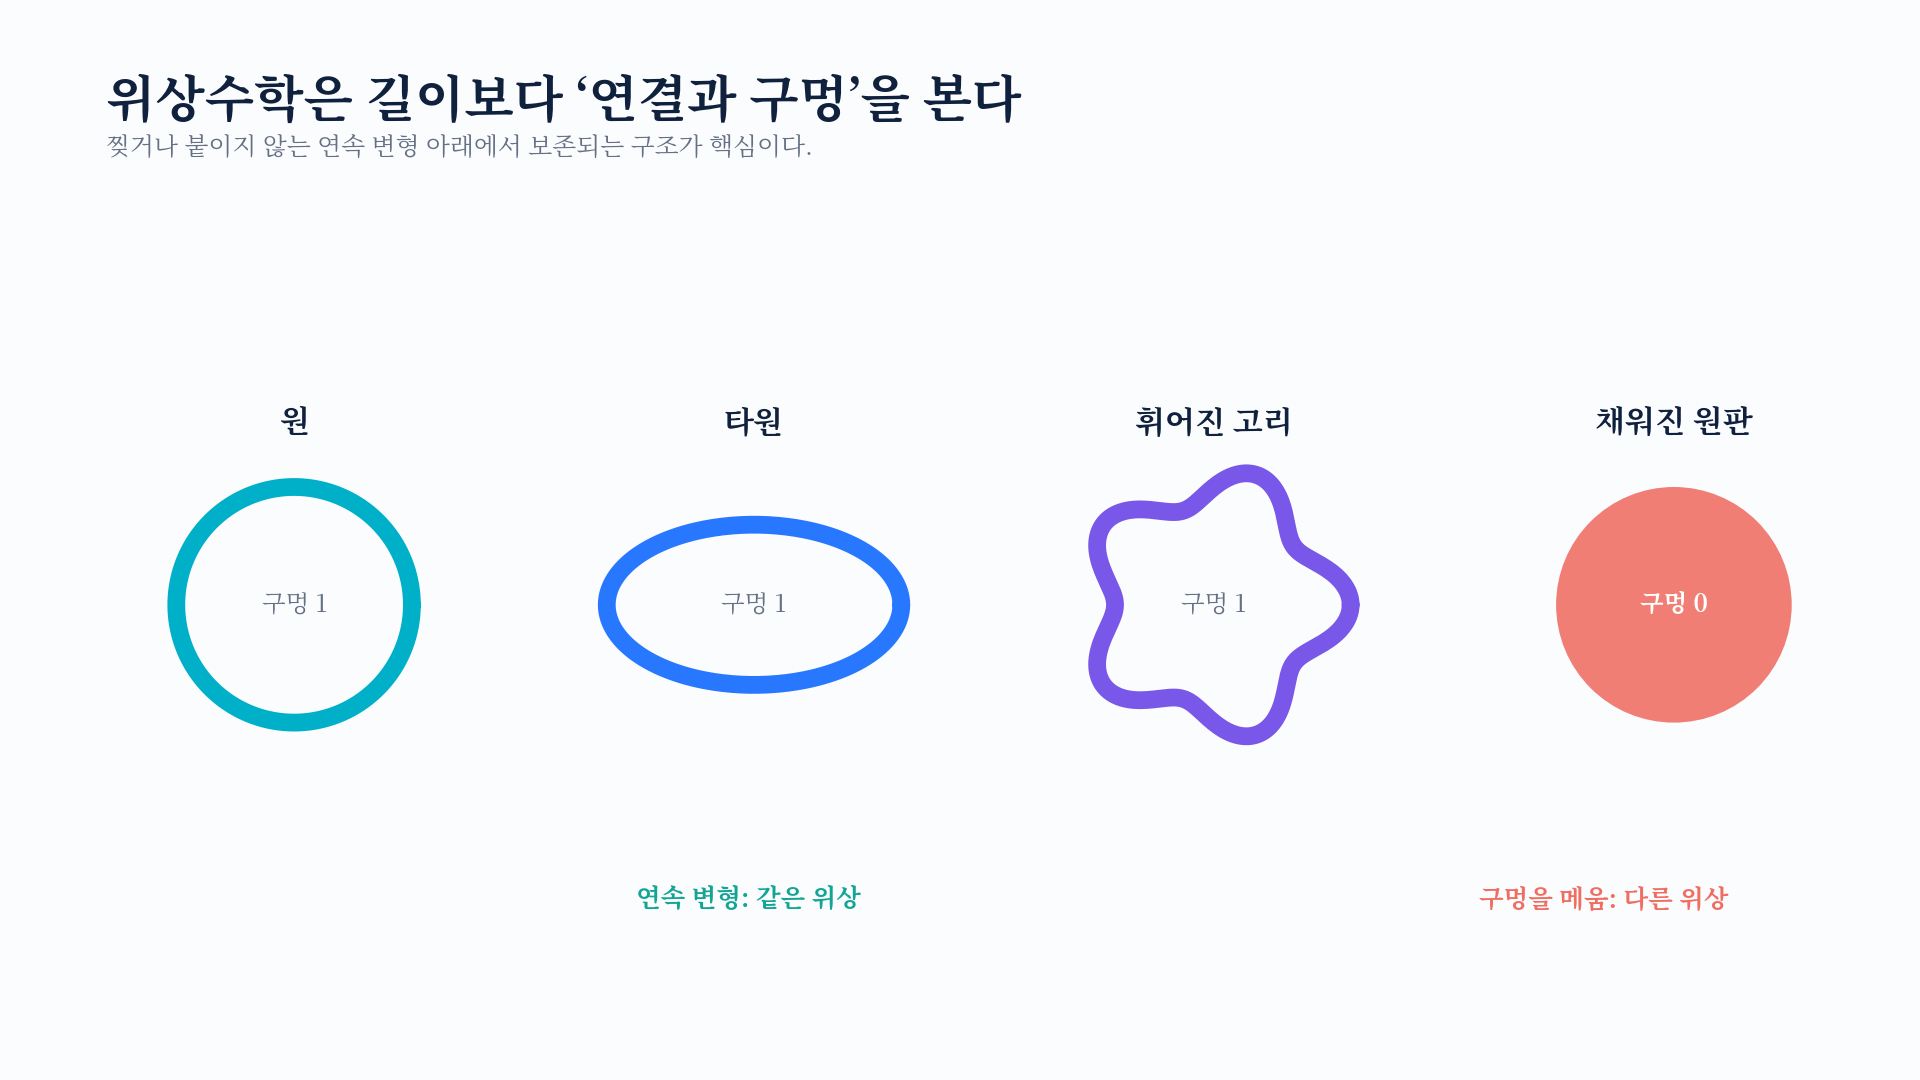
기하학이 길이, 각도, 곡률을 묻는다면 위상수학은 찢거나 붙이지 않는 연속 변형에도 남는 성질을 묻는다. 원을 늘이면 타원이 되고 울퉁불퉁하게 휘어도 여전히 고리다. 반대로 가운데를 채워 원판으로 만들면 구멍이 사라지므로 위상이 달라진다.
원, 타원, 휘어진 고리와 채워진 원판의 위상 비교
이 관점이 데이터 분석에 유용한 이유는 세 가지다.
-
좌표보다 관계를 본다. 분석은 좌표의 이름 자체보다 선택한 거리 또는 유사도에 의해 결정된다. 서로 다른 좌표계라도 같은 거리 구조를 보존하면 비교할 수 있다.
-
작은 변형에 덜 민감한 요약을 노린다. 표본의 미세한 흔들림보다 오래 유지되는 연결과 구멍에 집중할 수 있다.
-
복잡한 모양을 유한한 조합 구조로 압축한다. 수많은 점을 작은 graph나 simplicial complex로 바꿔 읽는다.
여기서 중요한 단서가 있다. “좌표와 무관하다”는 말은 거리 선택과 전처리까지 무관하다는 뜻이 아니다. Euclidean distance를 쓸지 correlation distance를 쓸지, 변수의 스케일을 어떻게 맞출지는 결과를 크게 바꾼다. TDA는 가정이 없는 도구가 아니라, 가정을 거리·렌즈·cover·군집화의 형태로 드러내는 도구에 가깝다.
2. Mapper: 고차원 점군을 읽을 수 있는 network로
Mapper는 모든 점을 그대로 그리는 대신, 데이터의 흐름을 작은 network로 압축한다. node는 비슷한 표본의 작은 집합이고, 두 node가 원래 표본을 공유하면 edge로 연결된다.
Mapper의 네 단계
점군을 $X=\{x_1,\dots,x_n\}$, 거리 함수를 $d$, 렌즈 또는 filter를 $f:X\rightarrow\mathbb{R}^p$라 하자.
-
렌즈를 고른다. 각 점을 시간, 밀도, 위험 점수, 주성분, 중심성 같은 값 $f(x)$로 보낸다.
-
렌즈 값의 범위를 겹치는 구간으로 덮는다. cover의 원소를 $U_1,U_2,\dots$라 한다. 구간을 겹치는 이유는 이웃 구간 사이의 흐름을 보존하기 위해서다.
-
각 pullback $f^{-1}(U_j)$ 안에서 군집화한다. 한 구간에 들어온 점들이 공간상 여러 덩어리라면 분리한다. 각 부분 군집이 Mapper의 node가 된다.
-
공유 표본으로 연결한다. 두 부분 군집이 같은 원본 점을 하나라도 포함하면 edge를 긋는다.
Mapper의 렌즈, cover, 군집화, nerve 연결 단계
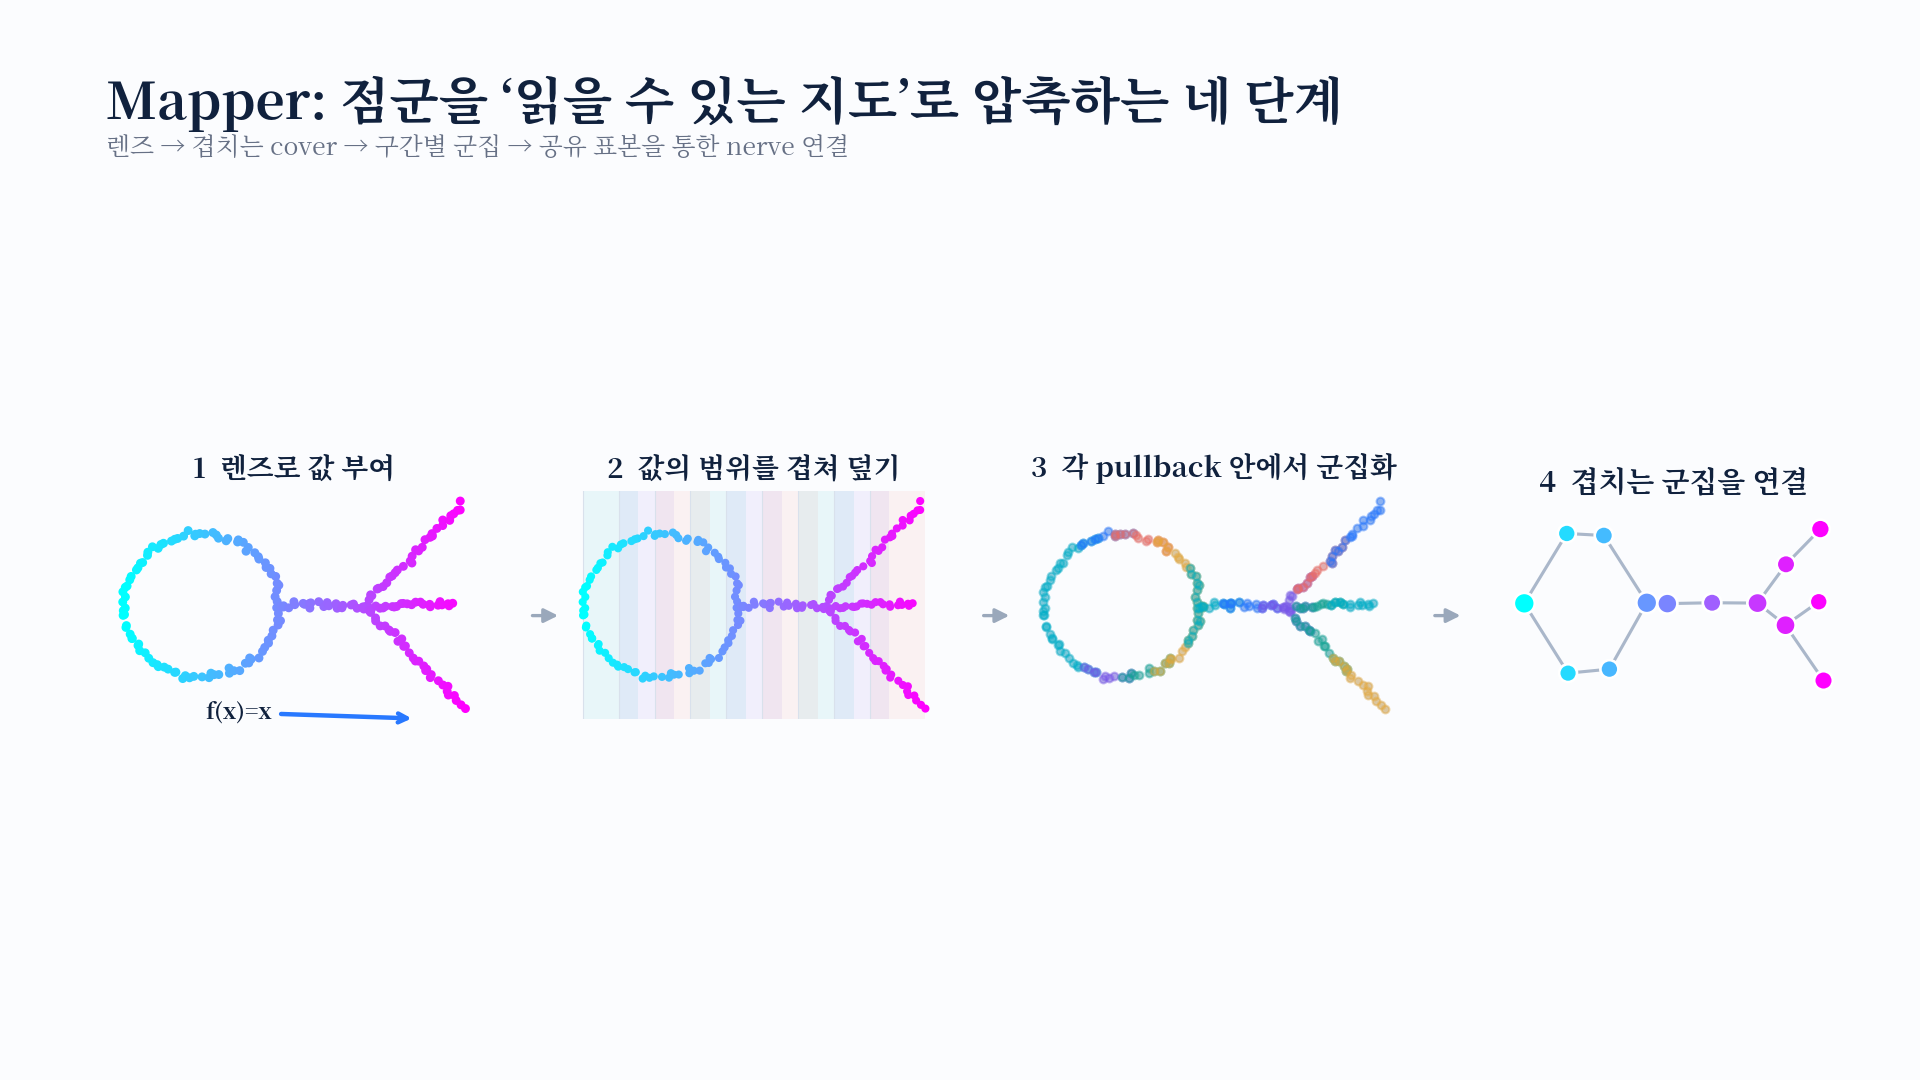
조금 더 형식적으로, pullback cover의 군집들을 $\mathcal{C}=\{C_\alpha\}$라 하자. Mapper는 이 집합족의 nerve다.
일반적인 Mapper 그림은 이 nerve의 1-skeleton, 즉 node와 edge까지만 표시한다. 두 개보다 많은 cover 원소가 함께 겹치면 triangle이나 더 높은 차원의 simplex도 생길 수 있다.
Nerve theorem은 무엇을 보장하고, 무엇을 보장하지 않을까?
Nerve theorem에 따르면 cover의 모든 유한 교집합이 비어 있거나 수축 가능한 good cover라면, cover의 nerve는 원래 공간과 homotopy equivalent하다. 연결 성분과 구멍 같은 위상 정보를 보존한다는 뜻이다.
하지만 유한 표본에서 임의의 렌즈와 군집화를 사용해 만든 Mapper가 자동으로 good cover 조건을 만족하는 것은 아니다. 실전 Mapper는 Reeb graph의 계산 가능한 근사로 이해하는 편이 안전하며, 이론적 근사·안정성 보장은 표본, 함수, cover와 scale에 대한 조건을 요구한다. 따라서 “Mapper 그림이 나왔으니 원래 데이터의 위상이 증명됐다”고 말하면 안 된다.
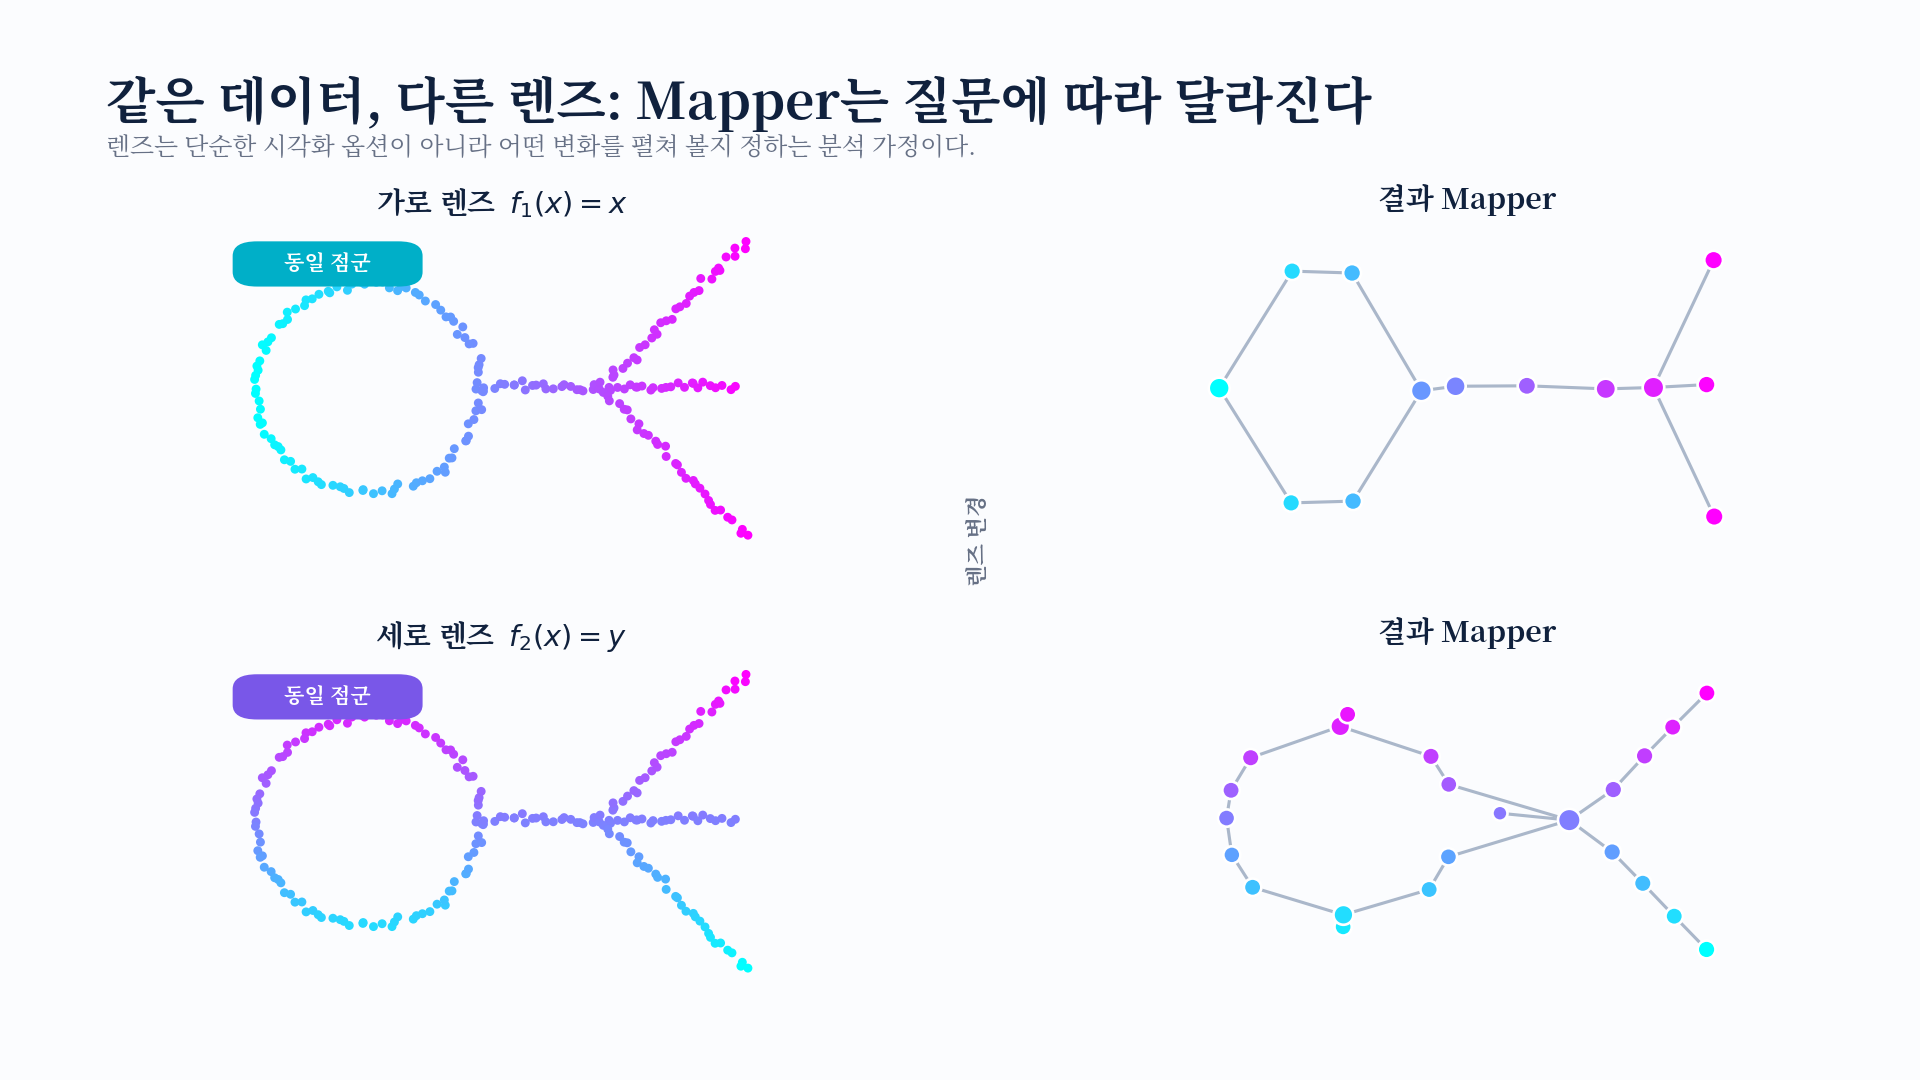
렌즈는 곧 질문이다
같은 점군도 가로 방향으로 펼칠지, 세로 방향으로 펼칠지에 따라 서로 다른 Mapper가 나온다.
같은 점군에 가로 렌즈와 세로 렌즈를 적용한 Mapper 비교
-
시간을 렌즈로 쓰면 진행 경로와 전환 시점을 보기 쉽다.
-
밀도 또는 중심성을 쓰면 중심부와 주변부, 희소한 flare를 펼쳐 볼 수 있다.
-
위험 점수나 임상 단계를 쓰면 도메인 해석이 쉬워지지만 supervised information을 넣었다는 사실을 명시해야 한다.
-
PCA 좌표를 쓰면 산점도의 방향을 압축된 network로 볼 수 있지만, PCA가 놓친 구조를 자동으로 복구하는 것은 아니다.
좋은 습관은 렌즈 하나를 “정답”으로 고르는 대신, 사전에 정한 소수의 렌즈와 파라미터 범위에서 반복적으로 나타나는 구조를 확인하는 것이다.
Mapper 그림을 읽는 세 가지 질문
| 선택 | 바꾸는 것 | 확인할 질문 |
| Lens $f$ | 데이터를 펼치는 관점 | 분석 질문과 직접 연결되는가? label leakage는 없는가? |
| Cover | 구간 수와 overlap | 해상도를 바꿔도 branch와 loop가 유지되는가? |
| Clustering | node의 의미 | 거리와 threshold가 도메인에 맞는가? singleton이 과도하지 않은가? |
node의 화면 좌표는 force-directed layout 같은 배치 알고리즘이 정할 수 있으므로, 위·아래 또는 좌·우 위치 자체를 해석하면 안 된다. 연결 관계, node가 담은 표본, node size, 색상으로 입힌 변수의 분포를 함께 읽어야 한다.
3. 실제 사례: Mapper는 무엇을 발견 후보로 만들었나?
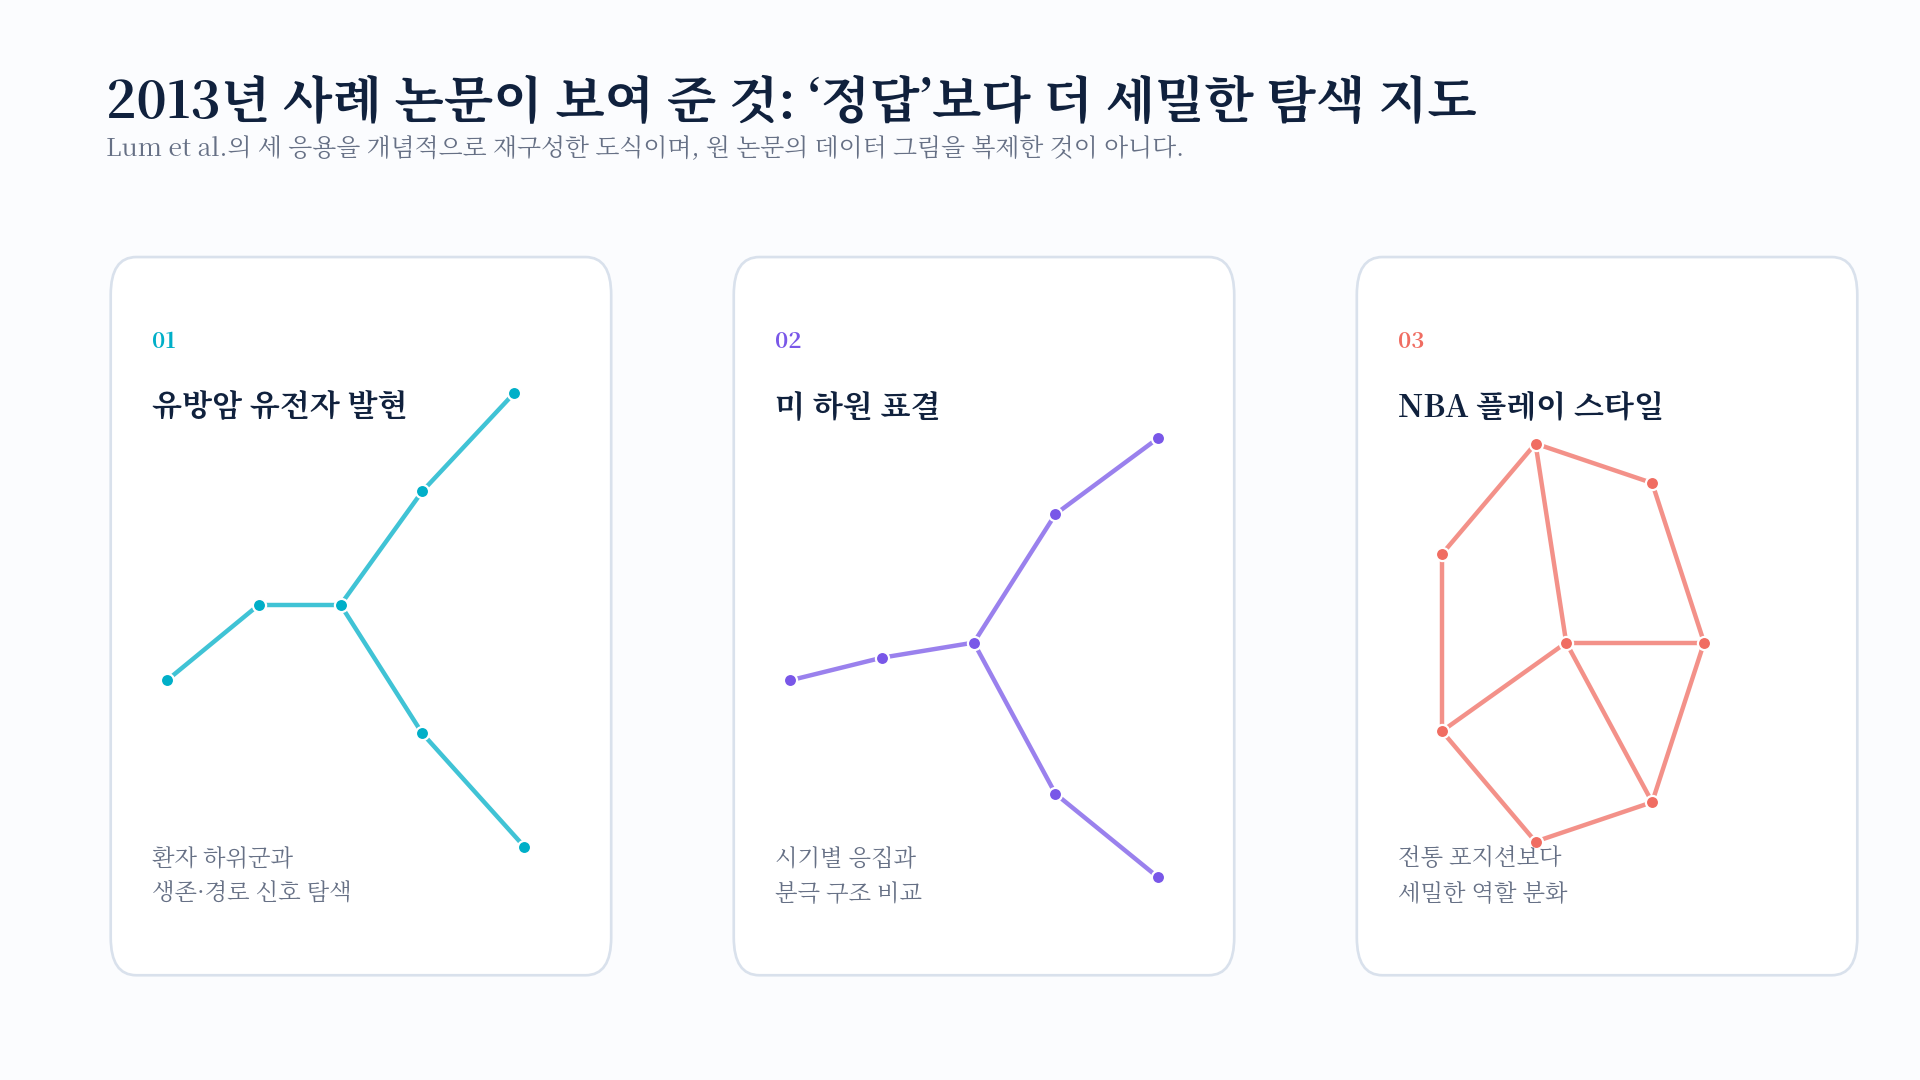
Lum et al.의 2013년 논문은 세 사례로 Mapper의 탐색적 역할을 보였다.
유방암 유전자 발현, 하원 표결, NBA 플레이 스타일의 Mapper 활용 사례
-
유방암 유전자 발현: 서로 다른 microarray 데이터에서 환자 network를 구성하고, ESR1 발현과 생존·pathway 신호로 색칠해 세부 하위군을 탐색했다.
-
미국 하원 표결: 여러 의회 회기의 표결 network를 비교해 응집과 분극의 구조가 시간에 따라 어떻게 달라지는지 살폈다.
-
NBA 선수 성과: 2010–2011 시즌 452명의 성과 profile을 Mapper로 표현하고, 전통적인 5개 포지션보다 세밀한 13개 역할 유형을 저자들이 해석했다.
이 결과를 읽을 때 “TDA가 13개 진짜 포지션을 증명했다”가 아니라, “해당 거리·렌즈·해상도에서 후속 검토할 세밀한 역할 분화가 나타났다”고 표현하는 것이 맞다. 논문 자체도 flare의 유의성을 Gaussian null simulation과 persistence 방식으로 별도 검토했다. 그림을 발견 도구로 쓰고, 주장은 다시 검증하는 것이 TDA의 올바른 사용법이다.
4. Persistent homology: 여러 scale에서 살아남는 신호
Mapper가 사람이 읽기 좋은 지도를 만든다면, persistent homology는 연결 성분과 구멍이 scale에 따라 얼마나 오래 유지되는지 수치화한다.
연속 공간을 계산 가능한 조각으로
-
0-simplex: 점
-
1-simplex: edge
-
2-simplex: 채워진 triangle
-
3-simplex: tetrahedron
대표적인 구성인 Vietoris–Rips complex $VR_\varepsilon(X)$는 거리 문턱 $\varepsilon$를 정하고, 모든 쌍의 거리가 $\varepsilon$ 이하인 점 집합을 simplex로 채운다. $\varepsilon$를 키우면 complex가 중첩되며 자란다.
이 중첩된 열을 filtration이라 한다.
거리 문턱에 따라 점, edge, triangle이 추가되는 Vietoris–Rips filtration
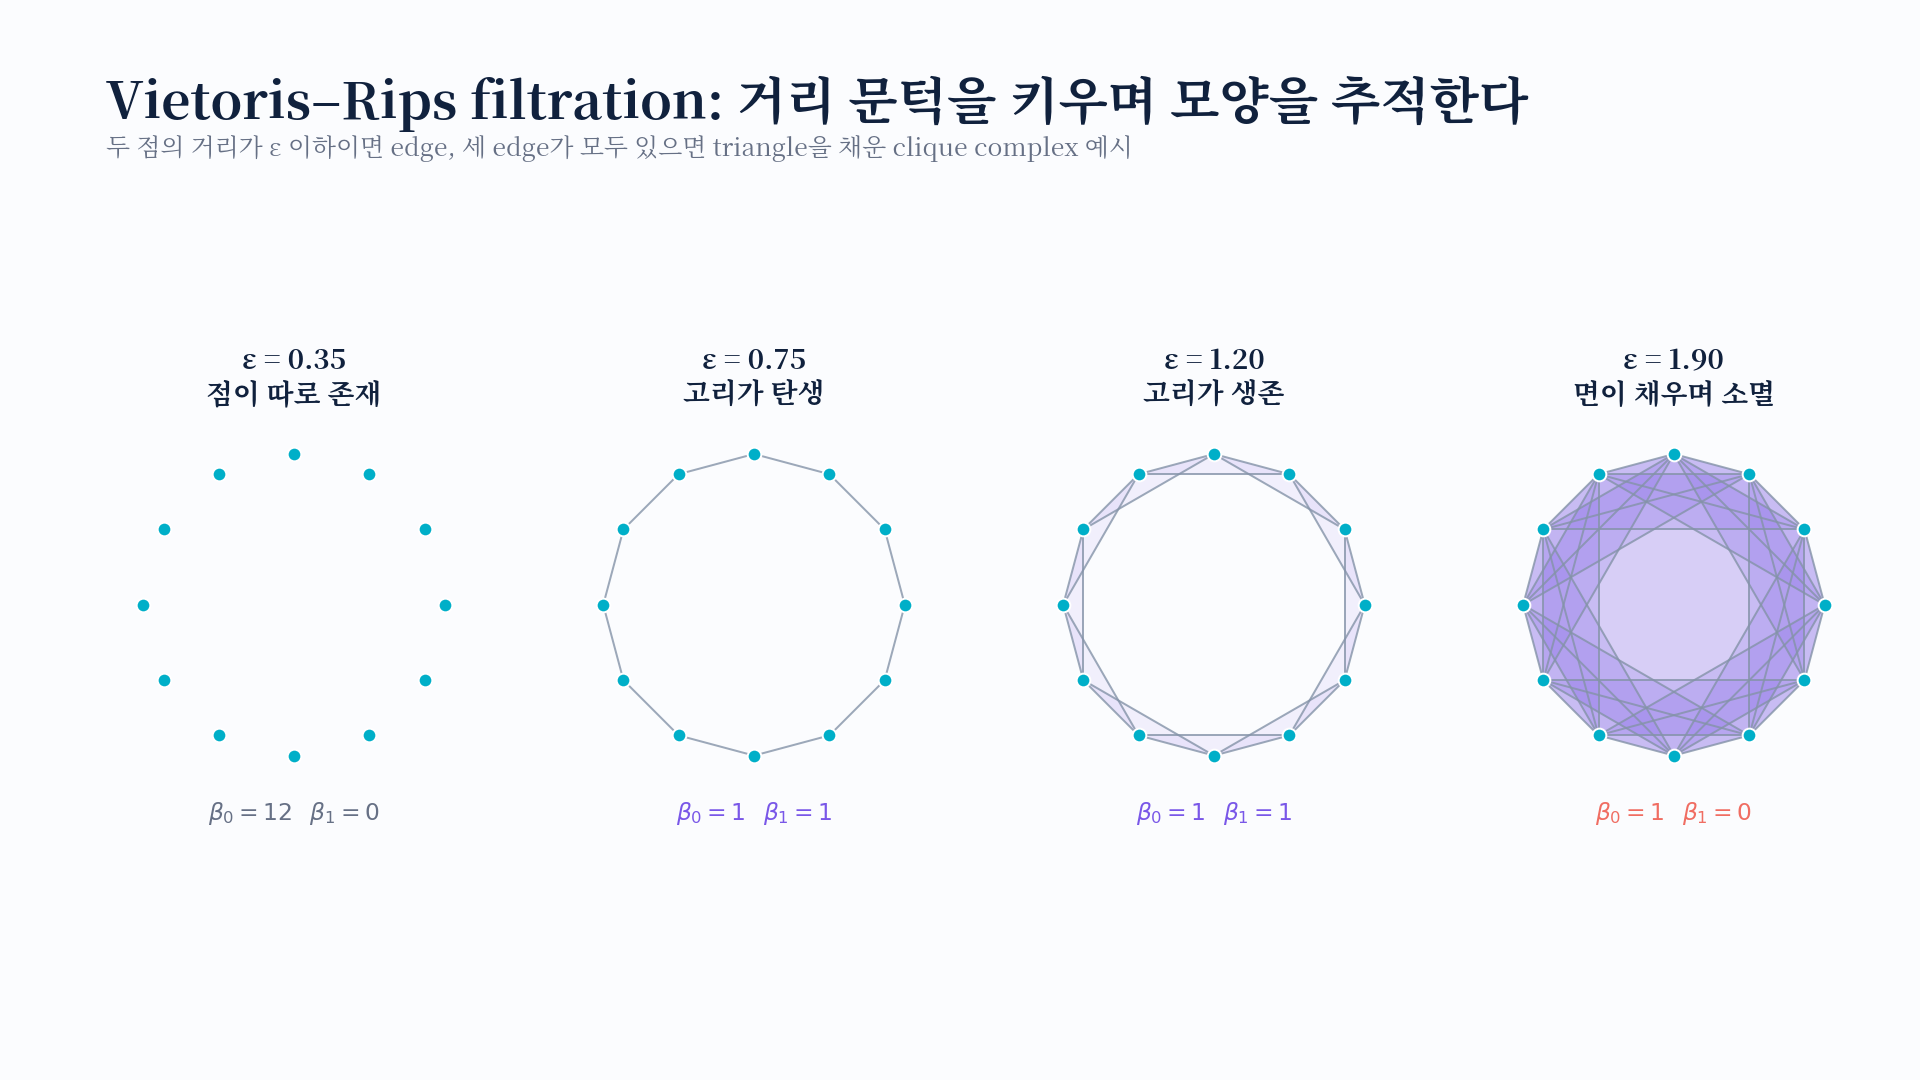
Homology는 차원별 구멍을 센다. 그 개수를 Betti number $\beta_k$로 쓴다.
-
$\beta_0$: 연결 성분의 수
-
$\beta_1$: 독립적인 loop의 수
-
$\beta_2$: 3차원에서 빈 공간을 감싸는 cavity의 수
Birth, death, persistence
filtration을 따라가면 특징이 처음 생기는 birth와 다른 구조에 합쳐지거나 채워져 사라지는 death를 기록할 수 있다.
Barcode와 persistence diagram으로 표현한 특징의 수명
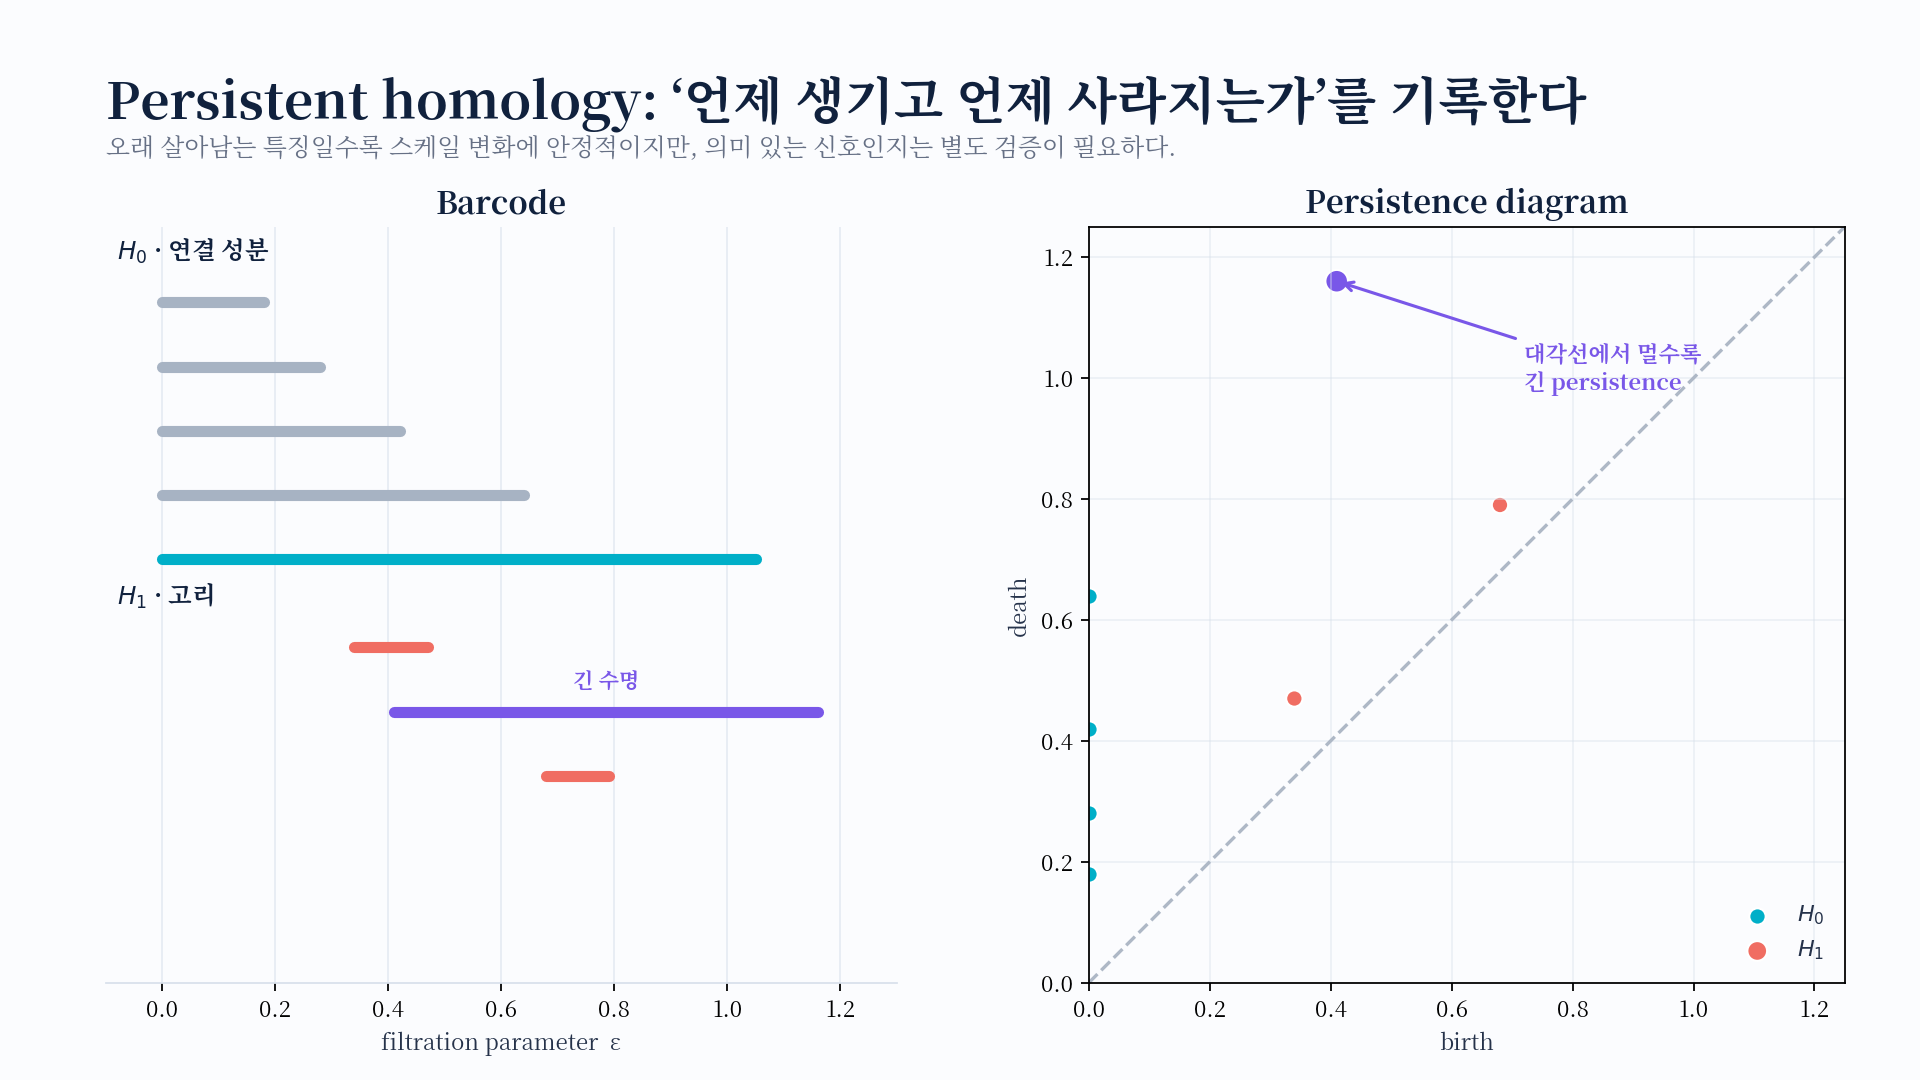
-
Barcode: 각 특징의 수명을 가로 막대로 그린다.
-
Persistence diagram: 특징을 $(birth, death)$ 점으로 그린다. 대각선에서 멀수록 수명이 길다.
긴 bar는 scale 변화에 안정적인 후보라는 뜻이지, 자동으로 중요한 과학적 신호라는 뜻은 아니다. 주기적 과정이 loop를 만들 수도 있지만, sampling bias나 전처리가 빈 영역을 만들어 가짜 loop를 만들 수도 있다. 반대로 짧은 bar도 작은 생물학적 하위군처럼 실제로 중요한 fine-scale 구조일 수 있다.
Mapper와 persistent homology의 역할 차이
| Mapper | Persistent homology | |
| 주목적 | 탐색·시각화·하위군 해석 | 다중 scale 위상 특징의 정량 요약 |
| 주요 입력 선택 | metric, lens, cover, clustering | metric, complex, filtration |
| 출력 | graph 또는 simplicial complex | barcode, persistence diagram |
| 잘 답하는 질문 | 어디서 갈라지고 어떤 표본이 branch에 있는가? | 어떤 연결·구멍이 얼마나 오래 지속되는가? |
| 대표 위험 | lens와 파라미터에 따른 구조 변화 | sampling, metric, scale에 따른 가짜/누락 특징 |
둘은 경쟁 도구가 아니다. Mapper graph에 filtration을 정의하고 그 persistent homology를 계산하는 것처럼 함께 쓸 수도 있다.
5. Differentiable Mapper: 렌즈도 학습할 수 있을까?
표준 Mapper의 까다로운 점은 파라미터, 특히 렌즈를 사람이 정해야 한다는 것이다. 구간 경계에서 한 점의 소속이 0에서 1로 갑자기 바뀌고, 이어지는 군집과 nerve도 불연속적으로 변하므로 보통의 gradient optimization을 바로 적용하기 어렵다.
Oulhaj, Carrière, Michel은 2024년 Soft Mapper를 제안했다. 핵심은 점 $x_i$가 cover 원소 $j$에 들어가는지를 고정된 binary 값으로 두는 대신 Bernoulli random variable로 만드는 것이다.
구간 내부에서는 $q_j=1$이고 경계 바깥의 폭 $\delta$에서 확률이 부드럽게 0으로 내려간다. 이렇게 표본마다 latent cover assignment를 sampling하면 하나의 Mapper가 아니라 Mapper complex 위의 분포를 얻는다.
Standard Mapper의 hard assignment와 Soft Mapper의 확률적 cover assignment
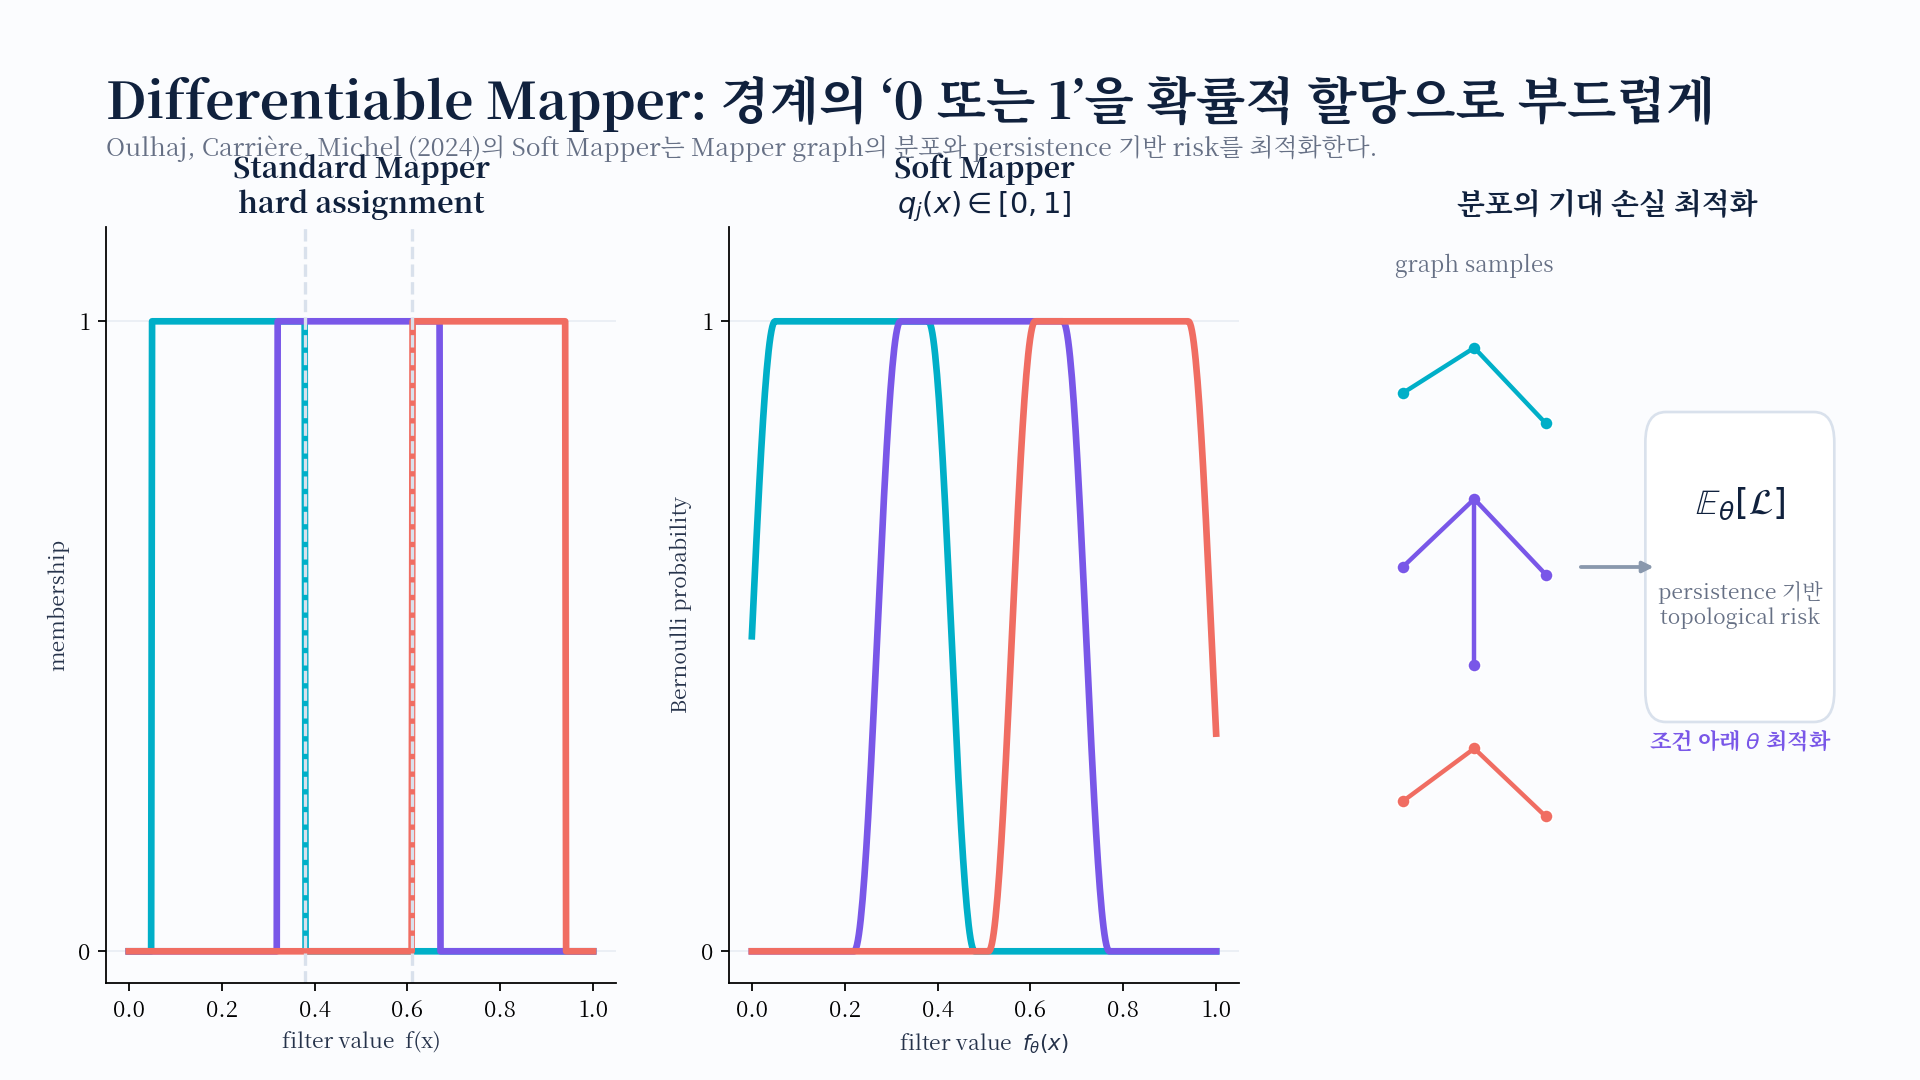
논문의 최적화 흐름은 다음과 같다.
-
파라미터화된 렌즈 $f_\theta:X_n\rightarrow\mathbb{R}$를 정한다.
-
$f_\theta$로 부드러운 cover assignment 확률을 만든다.
-
각 assignment가 만드는 Mapper graph에 extended persistence diagram을 계산한다.
-
persistence 기반 loss $\ell$의 기대값을 topological risk로 둔다.
저자들은 definability와 local Lipschitz 조건 아래 이 risk에 대한 최적화 보장을 제시했다. 실험에서는 3D 사람·문어·탁자 point cloud에 선형 렌즈 $f_\theta(x)=\langle x,\theta\rangle$를 적용하고, total persistence를 크게 만드는 방향을 찾아 더 구조적인 skeleton을 얻었다고 정성 평가했다.
여기에도 경계가 있다.
-
모든 persistent homology 계산이 어디서나 매끄럽다는 뜻은 아니다. 논문의 보장은 명시한 정칙성 조건 아래의 local Lipschitz·definable risk에 관한 것이다.
-
실험은 3D shape의 skeleton 품질을 보여 주는 사례다. 예측 성능이나 모든 종류의 데이터에서 최적 렌즈를 보장한 결과는 아니다.
-
clustering algorithm은 고정된 구성요소다. lens를 학습해도 metric, cover, clustering 선택은 남는다.
즉 Differentiable Mapper는 “사람의 판단을 없애는 자동 Mapper”보다, 위상적 목적을 렌즈 학습에 연결하는 연구 프레임으로 이해하는 편이 정확하다.
6. TDA와 Topological Deep Learning은 같은 것일까?
용어가 넓게 쓰이면서 세 층이 자주 섞인다.
Core TDA, topological loss, Topological Deep Learning의 역할 구분
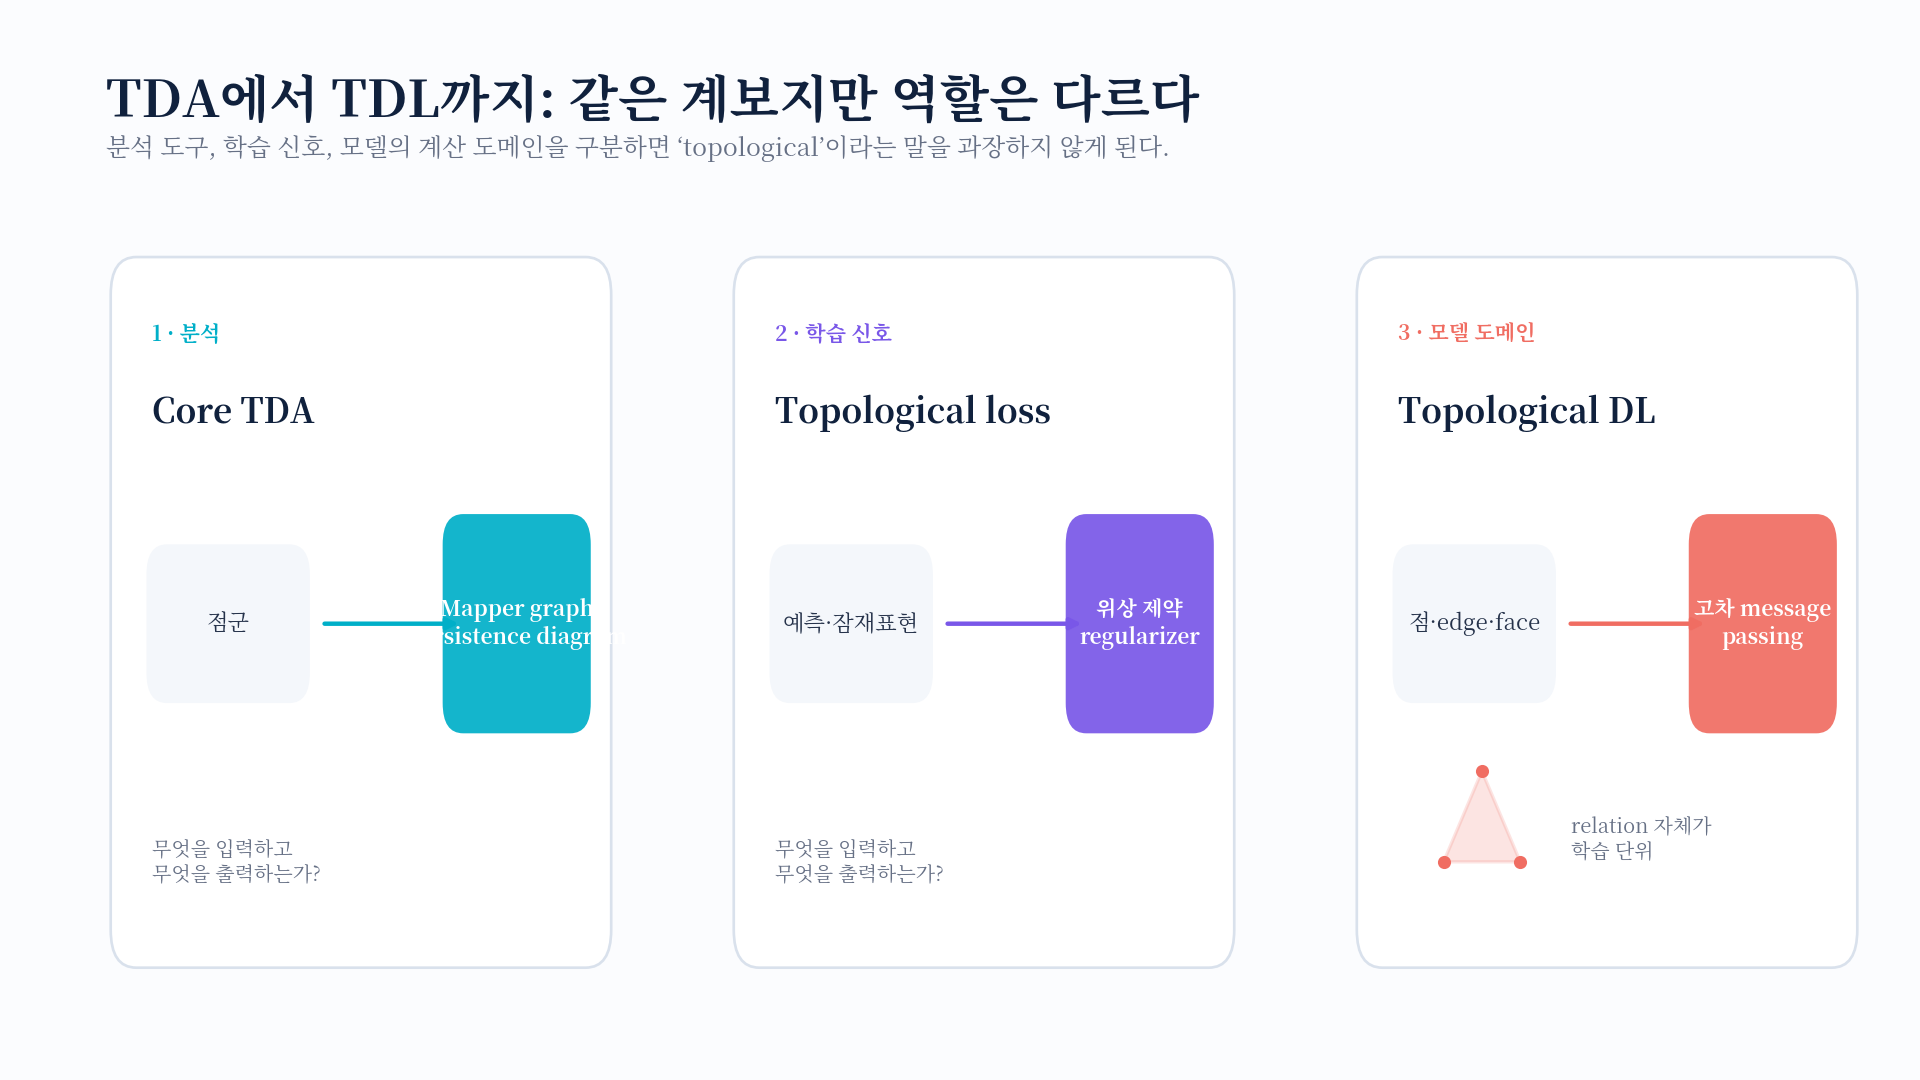
1) Core TDA: 데이터를 분석한다
Mapper와 persistent homology로 point cloud의 모양을 graph와 persistence diagram으로 요약한다. 출력은 사람이 해석하거나 downstream model의 feature로 사용할 수 있다.
2) Topological loss: 학습에 위상 제약을 건다
모델의 예측이나 latent representation에서 원하는 연결 성분과 구멍이 생기도록 persistence 기반 loss 또는 regularizer를 더한다. 위상은 모델 구조가 아니라 학습 신호로 작동한다.
3) Topological Deep Learning(TDL): 관계 구조 위에서 학습한다
일반 graph는 vertex와 두 vertex 사이의 edge라는 pairwise relation을 표현한다. TDL은 simplicial complex, cell complex, hypergraph 같은 도메인에서 점·edge·face와 고차 관계 자체에 feature를 두고 message passing을 수행한다.
표현력의 범위가 넓어지는 대신 저장·연산 비용이 커지고, 어떤 고차 구조를 만들어야 하는지라는 설계 문제가 생긴다. 공개 benchmark도 image·text에 비해 제한적이다.
따라서 TDA를 단순히 “AI 안의 한 알고리즘”으로만 넣는 것은 좁고, TDL까지 모두 같은 방법이라고 부르는 것은 넓다. TDA는 applied topology에서 출발한 분석 도구군이며 machine learning pipeline 안팎에서 쓸 수 있다. TDL은 그 아이디어와 구조를 deep learning architecture로 확장한 영역이다.
7. 실전에서 TDA를 시작하는 순서
Step 1. 먼저 데이터 질문을 문장으로 쓴다
“예쁜 network를 만들고 싶다”가 아니라 다음처럼 쓴다.
-
시간에 따라 하나의 상태가 두 경로로 분기하는가?
-
정상군과 이상군 사이에 연속적인 전이 경로가 있는가?
-
주기적 과정에 해당하는 loop가 여러 scale에서 유지되는가?
Step 2. metric과 전처리를 고정한다
결측치 처리, normalization, distance를 기록한다. 같은 알고리즘이라도 Euclidean과 correlation distance는 다른 질문을 한다. 고차원에서 거리 집중이 심한지도 확인한다.
Step 3. 작은 렌즈 portfolio를 사전 정의한다
도메인 변수, density·centrality, PCA 좌표 등 질문과 연결되는 렌즈만 고른다. 결과를 본 뒤 유리한 렌즈만 남기는 방식은 탐색 편향을 만든다.
Step 4. 단일 그림이 아니라 stability를 본다
cover resolution, overlap, clustering threshold를 바꿔 parameter sweep을 수행한다. bootstrap subsample에서도 핵심 branch와 loop가 재현되는지 확인한다.
Step 5. 구조를 원본 표본으로 되돌려 읽는다
branch 끝, loop 주변, 연결부 node에 실제로 어떤 표본이 들어 있는지 추적한다. node별 색상 평균만 보지 말고 분포와 sample count를 확인한다.
Step 6. 발견과 검증을 분리한다
한 데이터에서 구조를 찾았다면 독립 cohort, holdout, permutation 또는 적절한 null simulation으로 검증한다. Mapper topology를 고르는 데 사용한 label로 같은 구조의 유의성을 다시 주장하면 순환 논리가 된다.
Step 7. 재현 가능한 분석 명세를 남긴다
최소한 아래 항목을 보고한다.
data / feature set / preprocessing
metric
lens definition and whether labels were used
cover resolution and overlap
clustering algorithm and threshold
node size and color aggregation rule
parameter sweep / bootstrap range
statistical validation and held-out data
마치며: TDA가 주는 가장 중요한 질문
TDA의 핵심은 복잡한 수식보다 질문의 전환에 있다.
“몇 개의 군집이 있는가?”에서 “그 군집들은 어떻게 이어지고, 어디서 갈라지며, 어떤 구멍을 남기는가?”로.
Mapper는 고차원 데이터의 흐름을 사람이 읽을 수 있는 지도로 압축한다. Persistent homology는 그 구조가 여러 scale에서 얼마나 오래 살아남는지 기록한다. Soft Mapper는 topological objective로 렌즈를 학습하는 길을 열고, Topological Deep Learning은 pairwise graph를 넘어 고차 관계 위에서 학습한다.
다만 좋은 TDA 분석은 한 장의 인상적인 그림에서 끝나지 않는다. metric과 lens를 공개하고, 파라미터 변화에 대한 안정성을 확인하며, 발견한 구조를 원본 표본과 독립 데이터로 검증할 때 비로소 데이터의 모양이 과학적 설명이 된다.
참고 자료
-
Lum, P. Y., Singh, G., Lehman, A., et al. (2013). Extracting insights from the shape of complex data using topology. Scientific Reports, 3, 1236. https://doi.org/10.1038/srep01236
-
Oulhaj, Z., Carrière, M., & Michel, B. (2024). Differentiable Mapper for Topological Optimization of Data Representation. 2nd Differentiable Almost Everything Workshop at ICML 2024. https://arxiv.org/abs/2402.12854
-
Singh, G., Mémoli, F., & Carlsson, G. (2007). Topological Methods for the Analysis of High Dimensional Data Sets and 3D Object Recognition. PBG@Eurographics.
-
폴더 내 발표자료 Introduction to Topological Data Analysis: How to Read the Shape of Data (
TDA_TJ.pptx).
그림 안내: 표지 이미지는 이 글을 위해 생성했으며, 나머지 모든 기술 도식은 개념과 알고리즘을 바탕으로 새로 그렸다. 원 논문의 figure를 복제하지 않았다.