회로 최적화에도 ’지도’가 필요하다: TDA로 transistor sizing의 feasible island 찾기
회로 파라미터에서 여러 feasible island의 위상 지도를 거쳐 최적 설계점을 찾는 모습
ATLAS는 아날로그 회로의 transistor sizing을 위한 Bayesian optimization(BO)에 **Topological Data Analysis(TDA)**를 결합한다. 핵심은 회로도를 위상수학으로 분석하는 것이 아니다. Gaussian process가 예측한 near-feasible 설계점의 모양을 Mapper graph로 요약하고, 아직 덜 본 region·두 region 사이의 bridge·바깥 frontier에 SPICE 예산을 배분하는 것이다.
Analog Circuit Sizing · Bayesian Optimization · Topological Data Analysis · Mapper · Feasibility Search
왜 회로 최적화에 ’모양’이 필요할까?
아날로그 회로 sizing은 transistor width와 length, compensation capacitor, 저항, bias voltage 같은 설계 변수 $mathbf{x}$를 조절해 여러 성능 조건을 동시에 만족시키는 일이다.
- gain은 충분히 높아야 한다.
- unity-gain bandwidth와 phase margin도 기준을 넘어야 한다.
- power, bias current, delay, settling time은 상한보다 작아야 한다.
- LDO라면 dropout, load별 안정성, 주파수 구간별 PSRR까지 함께 맞아야 한다.
문제는 한 조건을 개선하면 다른 조건이 나빠질 수 있고, 후보 하나를 확인할 때마다 SPICE simulation 비용을 내야 한다는 점이다. Gradient를 직접 얻기도 어렵다. 그래서 적은 simulation으로 다음 후보를 고르는 BO가 잘 맞는다.
하지만 일반적인 acquisition function은 대개 다음 한 점의 기대 이득과 불확실성을 본다. 전체 feasible landscape가 몇 덩어리로 갈라졌는지, 지금 한 덩어리만 반복해서 보고 있는지는 모른다.
하나의 feasible island에 고착되는 일반 BO와 여러 region을 분산 탐색하는 TDA-guided BO
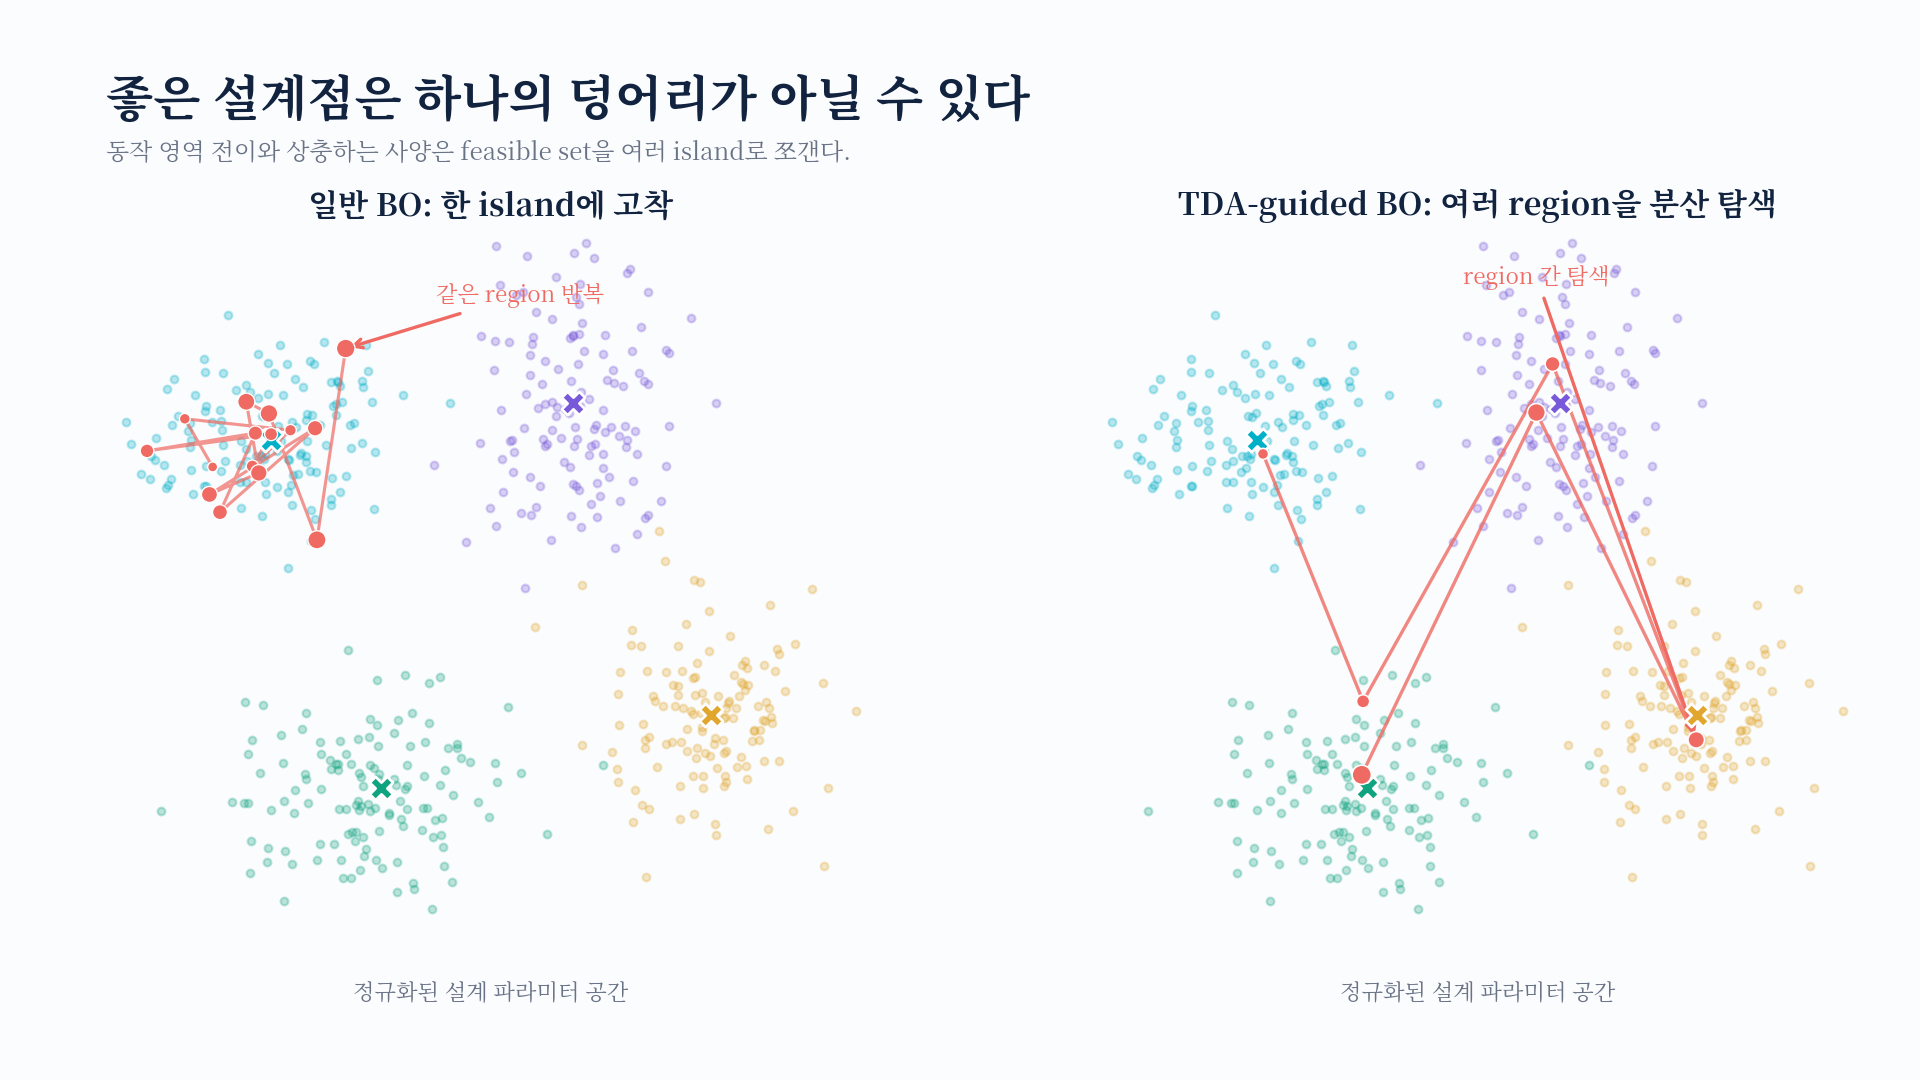
회로에서는 다음 이유로 feasible set이 여러 island로 갈라질 수 있다.
- 동작 영역 전이: weak/strong inversion, saturation/triode처럼 소자의 regime이 바뀐다.
- 사양 간 trade-off: gain, bandwidth, phase margin, power가 서로 다른 방향을 선호한다.
- 비선형 device physics: 같은 성능에 도달하는 서로 다른 bias와 sizing 전략이 존재할 수 있다.
기존 BO가 surrogate의 false-positive island 하나를 믿고 예산을 몰아주면, 그 island가 실제로는 infeasible일 때 budget 전체를 잃을 수 있다. 여러 predicted island에 query를 분산하면 이 위험을 hedge할 수 있다. 이것이 ICCAD 2026 논문 **“ATLAS: Adaptive TDA-guided Landscape-Aware Transistor Sizing”**의 출발점이다.
1. 먼저 문제를 수식으로 고정하자
고정된 circuit topology와 $d$개의 설계 변수를 생각하자.
SPICE simulator는 설계점 하나를 $S$개의 성능 지표로 바꾼다.
모든 사양을 lower-bound 형태로 맞추면 success set은 다음과 같다.
power나 delay처럼 작을수록 좋은 upper-bound 사양은 부호를 뒤집어 같은 꼴로 처리한다. 여기서 목표는 별도 figure of merit를 끝까지 최대화하는 것이 아니라, 가능한 적은 simulation으로 아무 설계점 하나라도 $mathbf{x}^{\ast}\in\mathcal{F}$를 찾는 것이다. 논문의 실험도 첫 feasible design을 찾으면 멈춘다.
이 목표 정의가 중요하다. ATLAS의 결과를 “전역 최적 설계를 찾았다”로 읽으면 안 된다. 정확한 주장은 다중 제약을 모두 만족하는 첫 설계를 더 적은 query로 찾는 feasibility search다.
2. TDA는 회로의 어디에 들어가는가?
ATLAS에서 GP 예측, Mapper 지도, candidate 분류, acquisition, SPICE가 순환하는 과정
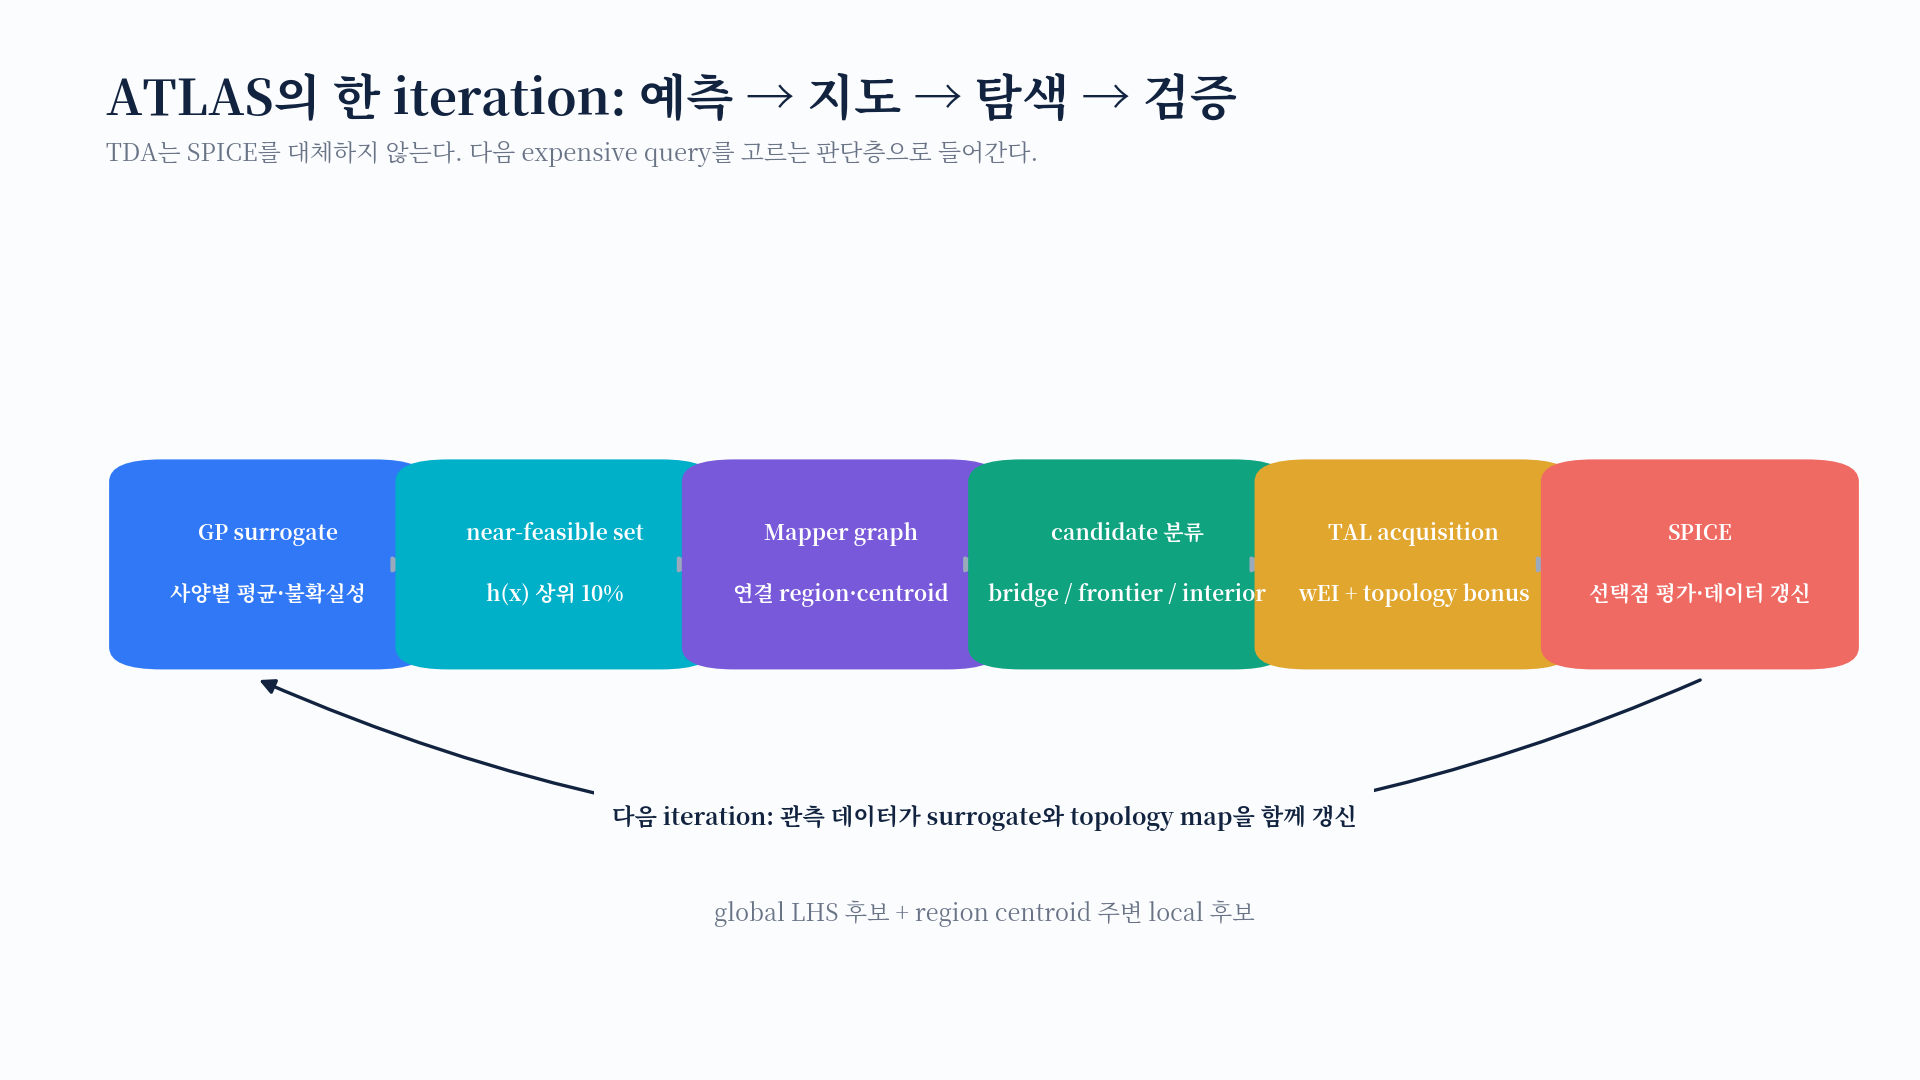
ATLAS의 TDA 대상은 netlist graph도, transistor 연결 topology도 아니다. 매 iteration에 surrogate가 만든 설계 파라미터 공간 속 near-feasible point cloud다.
| 층 | 입력 | 출력 | 역할 |
| Circuit | sizing vector $\mathbf{x}$ | SPICE metrics $g_s(\mathbf{x})$ | 비싼 ground-truth 평가 |
| Surrogate | 관측 데이터 $\mathcal{D}_t$ | $\hat\mu_s(\mathbf{x}),\hat\sigma_s(\mathbf{x})$ | 아직 평가하지 않은 후보의 성능과 불확실성 예측 |
| Feasibility score | 사양별 standardized margin | $h(\mathbf{x})$와 $\hat p(\mathbf{x})$ | 여러 사양을 하나의 검색 신호로 결합 |
| Mapper TDA | $h$가 높은 candidate point cloud | graph region, centroid, $\hat\beta_0$ | 예측된 feasible landscape의 연결 구조 요약 |
| Acquisition | wEI, region visit, topological class | 다음 query $\mathbf{x}_{t+1}$ | SPICE budget 배분 |
논문은 각 specification마다 독립적인 Gaussian process를 학습한다. kernel은 ARD를 포함한 Matérn 5/2다. 사양 $s$의 predictive mean과 standard deviation을 각각 $\hat\mu_s$, $\hat\sigma_s$라 하면, candidate의 가장 약한 사양 margin을 다음처럼 계산한다.
$h(\mathbf{x})>0$이면 surrogate는 모든 사양을 만족한다고 예측한다. 그러나 초기에는 그런 점이 하나도 없을 수 있다. 그래서 ATLAS는 $h>0$만 고집하지 않고, 큰 candidate pool에서 $h$가 높은 상위 $\kappa$ 비율을 고른다.
논문의 기본값은 $\kappa=0.10$, 즉 50,000개 후보 중 상위 10%다. 이 soft near-feasible set 덕분에 아직 실제 feasible point를 한 번도 보지 못한 첫 BO iteration부터 지형을 추정할 수 있다.
핵심 구분: Mapper는 실제 success set $\mathcal{F}$를 직접 보는 것이 아니라, 현재 surrogate가 그린 근사 $\widehat{\mathcal{F}}_t$를 본다. 따라서 graph가 바뀌는 이유에는 실제 landscape 구조뿐 아니라 surrogate uncertainty와 model error도 들어 있다.
3. Mapper는 predicted feasible set을 어떻게 지도로 바꾸나?
surrogate의 near-feasible 후보에서 h cover와 DBSCAN을 거쳐 Mapper region을 얻는 과정
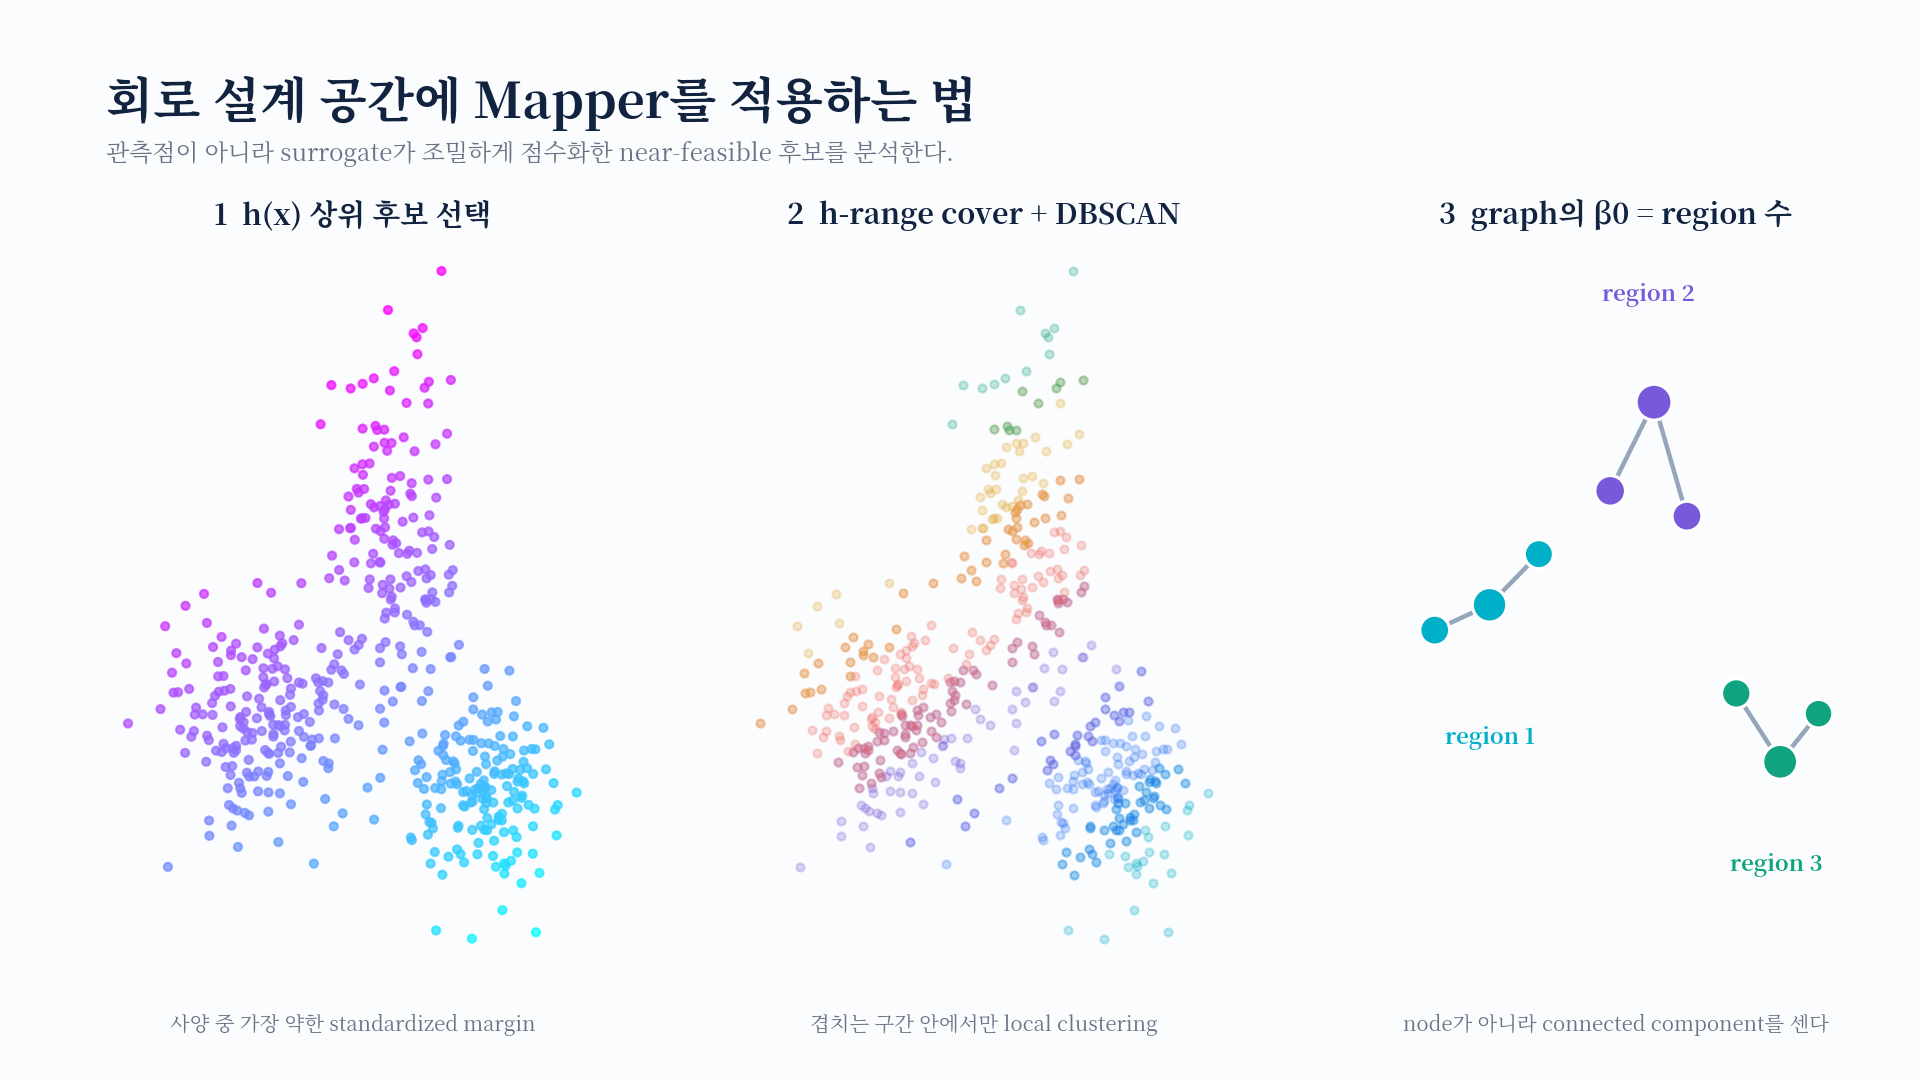
Mapper는 고차원 point cloud를 작은 graph로 압축한다. ATLAS에서는 filter 또는 lens로 바로 $h(\mathbf{x})$를 쓴다.
- Normalize: 서로 단위가 다른 width, capacitance, voltage를 비교할 수 있도록 모든 설계 변수를 $[0,1]^d$로 정규화한다.
- Cover: $h$의 범위를 서로 겹치는 $n_c$개 interval로 덮는다.
- Cluster: 각 interval의 preimage 안에서 DBSCAN을 수행한다.
- Graph: cluster 하나를 node로 만들고, overlap 때문에 같은 원본 point를 공유하는 node를 edge로 연결한다.
- Region: 완성된 Mapper graph의 connected component를 센다.
여기서 가장 자주 생기는 오해가 있다. ATLAS가 쓰는 region 수 $\hat\beta_0$는 DBSCAN cluster 수가 아니다. overlap을 통해 조립된 Mapper graph의 connected component 수다. DBSCAN은 각 cover 구간 내부의 local clustering 도구일 뿐이다.
논문의 공통 기본 설정은 다음과 같다.
| 항목 | 논문 기본값 | 의미 |
| Mapper interval 수 $n_c$ | 10 | $h$-range 해상도 |
| Cover overlap $\rho$ | 0.3 | 이웃 interval 사이의 연속성 보존 |
| DBSCAN `eps` | 0.3 | 정규화 공간의 local neighborhood |
| DBSCAN `min_samples` | 3 | core point 기준 |
| Mapper refresh $R$ | 3 iterations | 계산 결과를 중간 iteration에서 cache |
저자들은 이 한 설정을 회로·실험 run·iteration마다 바꾸지 않고 사용했다. 다만 이것을 “어떤 회로에도 맞는 universal constant”로 이해하면 곤란하다. 논문의 CMA sensitivity sweep에서는 12개 설정이 모두 10/10 success에 도달했지만, 첫 성공까지의 iteration 수는 설정별로 달랐다. 즉 success robustness와 search speed sensitivity는 동시에 봐야 한다.
논문이 direct persistent homology 대신 Mapper를 고른 이유는 두 가지다.
- connected region을 graph로 바로 읽고 centroid를 계산하기 쉽다.
- 논문의 구현·후보 규모에서는 Vietoris–Rips 기반 계산보다 Mapper의 DBSCAN 구성이 가볍다.
따라서 이 방법에서 TDA가 의미하는 것은 복잡한 모든 Betti number를 계산하는 것이 아니다. 주로 **0차 위상 정보, 즉 연결 성분 **$\beta_0$를 optimizer의 의사결정에 쓰는 것이다.
4. Bridge, frontier, interior: 다음 점의 ’정보 역할’을 분류한다
Mapper region 주변의 interior, 두 region 사이 bridge, 바깥 frontier 후보
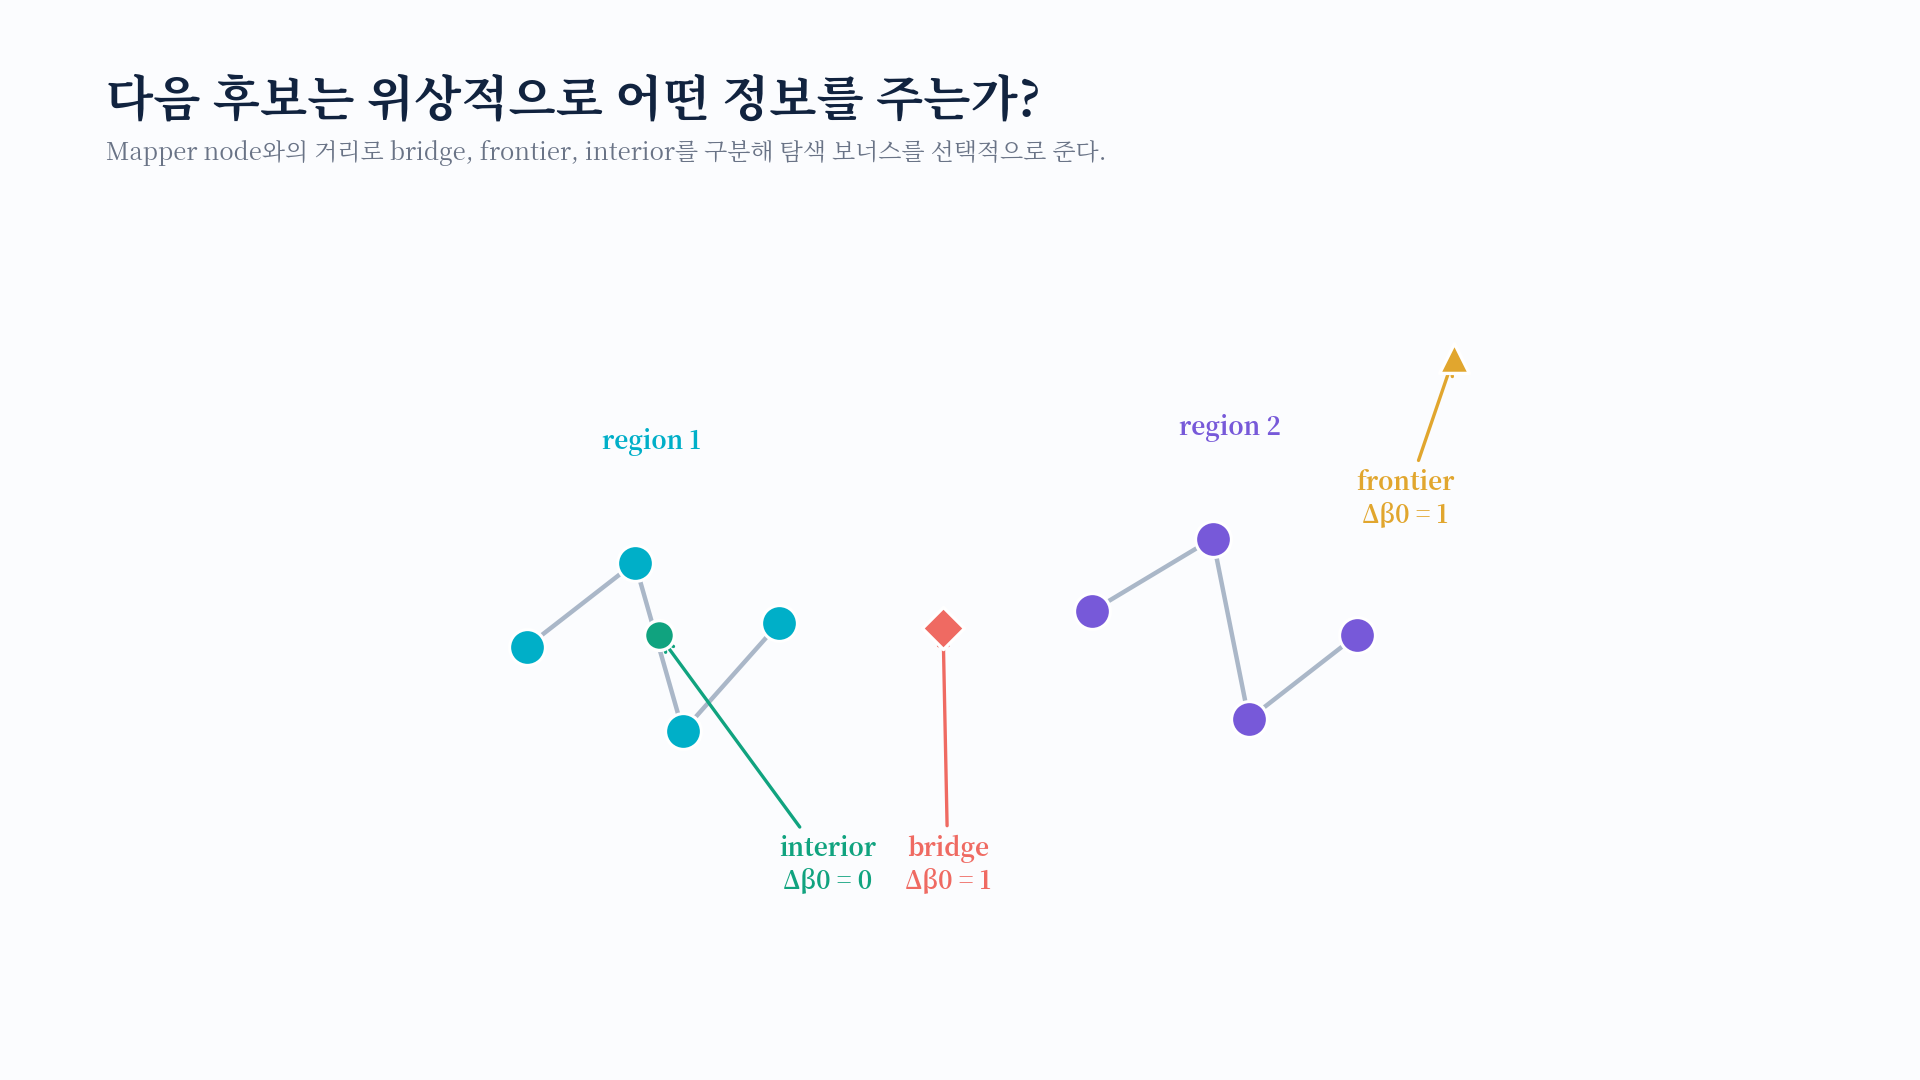
Mapper graph가 region ${C_1,\ldots,C_K\}$을 찾으면 각 candidate를 node까지의 거리로 분류한다. 기준 거리 $\epsilon^{\ast}$는 Mapper graph의 node 간 거리 중앙값으로 정해 매번 회로 scale에 맞춘다.
- Bridge, $\Delta\beta_0=1$: 두 개 이상 region의 node에서 $\epsilon^{\ast}$ 이내다. 실제로 두 region이 연결되는지 분리되는지 확인할 후보가 된다.
- Frontier, $\Delta\beta_0=1$: 모든 region에서 $\epsilon^{\ast}$보다 멀다. 아직 지도에 없는 새 region을 발견할 후보가 된다.
- Interior, $\Delta\beta_0=0$: 정확히 한 region 가까이에 있다. 해당 region을 정밀하게 다듬는 데는 유용하지만 새로운 연결 정보는 적다.
$\Delta\beta_0$는 candidate를 실제로 추가해 homology를 다시 계산한 값이 아니라, query가 estimated region count를 바꿀 가능성을 표시한 binary heuristic이다. 따라서 “bridge로 분류됐다”는 말은 두 실제 feasible region을 연결한다고 증명했다는 뜻이 아니다. 그 가능성을 SPICE로 확인할 가치가 있다는 뜻이다.
5. Topology를 acquisition function에 넣는 세 가지 장치
ATLAS는 세 질문을 동시에 다룬다.
| 질문 | 장치 | 효과 |
| 새 region이나 연결부가 어디인가? | $\Delta\beta_0$ exploration bonus | bridge·frontier query 우선 |
| 한 region을 너무 많이 봤는가? | region visit discount $d_k$ | under-explored region에 budget 재분배 |
| local search를 어디서 시작할까? | Mapper centroid anchor | 모든 발견 region 주변을 병렬로 정밀 탐색 |
5.1 출발점: feasibility-weighted EI
사양별 GP가 독립이라고 두면 joint predicted feasibility는 다음 곱으로 계산된다.
그리고 WEIBO 계열의 feasibility-weighted expected improvement는
로 쓴다. 아직 feasible incumbent가 없으면 논문은 높은 joint feasibility와 uncertainty를 선호하는 WEIBO fallback을 사용한다.
5.2 이미 많이 본 region은 할인한다
candidate가 가장 가까운 region $k^{\ast}$에 속하고, 그 region에서 지금까지 선택한 query 수가 $v_{k^{\ast}}$라면
만큼 wEI를 할인한다. $\hat\beta_0$가 바뀌어 region이 합쳐지거나 갈라지면 visit count를 reset한다. 과거 지도의 방문 기록이 새 지형을 잘못 억누르는 것을 막기 위해서다. region이 하나 이하라면 $v_k=0$으로 두어 discount를 끈다.
5.3 초기에는 topology, 후반에는 exploitation
region-discounted wEI와 topology bonus를 결합하고 budget 후반에 bonus를 줄이는 방식
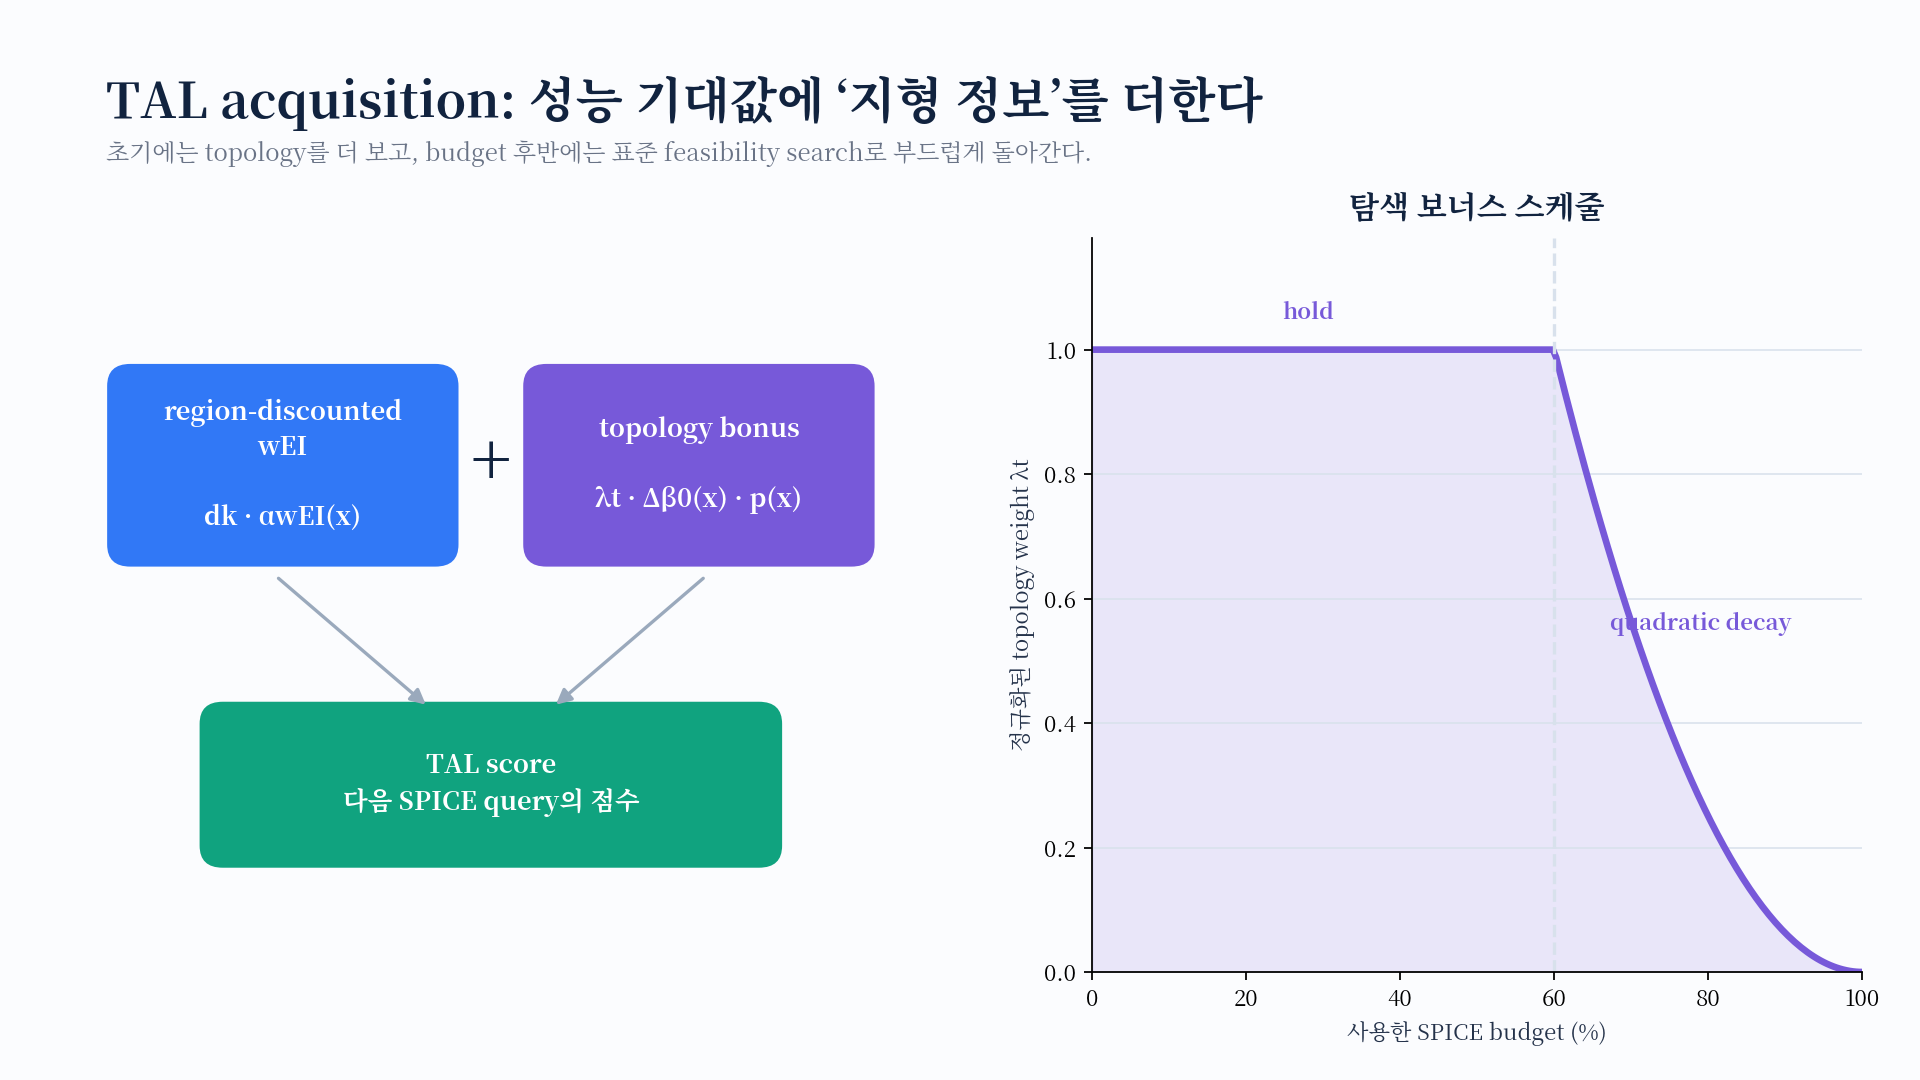
최종 topology-aware landscape acquisition(TAL)은 다음과 같다.
$\lambda_t$는 초반 $\tau T$까지 유지되고 이후 quadratic하게 감소한다. 논문의 $\tau$는 0.6이다. 최근 $W=10$ iteration 동안 $\hat\beta_0$가 안정적이면 exploitation을 앞당기고, 계속 변하면 exploration을 유지하도록 추가 조절한다. $\lambda_0$는 candidate pool의 positive wEI 중앙값으로 정해 서로 다른 회로에서도 acquisition scale을 자동으로 맞춘다.
$\lambda_t=0$이고 $d_k=1$이면 $\alpha_{\mathrm{TAL}}=\alpha_{\mathrm{wEI}}$가 된다. 즉 ATLAS는 논문 구현상 WEIBO를 topology term으로 확장한 형태다.
6. Topology는 점수뿐 아니라 candidate를 만드는 위치도 바꾼다
acquisition만 바꾸고 candidate pool이 한 region 주변에 몰려 있다면 새 island를 볼 수 없다. 그래서 ATLAS는 후보 생성 자체도 둘로 나눈다.
- Global candidates: Latin hypercube sampling(LHS)으로 전체 $\mathcal{X}$를 덮는다.
- Local candidates: anchor 주변을 Gaussian perturbation한다.
$K>1$이면 local anchor는 각 Mapper region의 centroid와 현재 가장 좋은 multi-spec point다. local budget은 이미 많이 방문한 region보다 덜 방문한 region에 더 많이 배정되며, acquisition discount와 같은 $1/\sqrt{1+v_k}$ 비율을 따른다.
$K\le1$이면 topology가 별도 region 정보를 주지 못하므로, 상위 multi-spec satisfaction point 주변을 탐색하는 표준 BO 방식으로 fallback한다. local perturbation radius도 budget 진행률에 따라 넓은 탐색에서 좁은 exploitation으로 감소한다.
이 설계는 “TDA score 하나를 기존 BO에 더했다”보다 조금 더 깊다. 어디에 후보를 만들지와 그 후보를 어떻게 점수화할지를 같은 region map으로 묶는다.
7. 실제 회로에 적용하는 구현 recipe
논문의 Algorithm 1을 엔지니어링 순서로 바꾸면 다음과 같다.
Step 1. 설계 변수와 hard bound를 고정한다
transistor group별 width/length, capacitor, resistor, bias를 vector $\mathbf{x}$로 만들고 물리적·PDK 제약을 bound에 넣는다. Mapper 거리 계산 전에는 반드시 $[0,1]^d$로 normalize한다.
Step 2. 모든 사양을 같은 방향으로 정렬한다
gain처럼 클수록 좋은 값과 power처럼 작을수록 좋은 값을 sign convention으로 통일한다. unit, corner, load, temperature 조건까지 specification key에 명시한다.
Step 3. 초기 LHS를 SPICE로 평가한다
논문은 $n_{\mathrm{init}}=3d$, 최대 50개를 사용한다. 동일한 초기 표본을 baseline끼리 공유해야 sample-efficiency 비교가 공정하다.
Step 4. 사양별 GP를 학습한다
각 $g_s$마다 Matérn 5/2 ARD GP를 fit하고 $\hat\mu_s$, $\hat\sigma_s$를 얻는다. calibration이 무너지면 $h$, $\hat p$, Mapper map이 함께 잘못되므로 uncertainty 품질을 별도로 점검해야 한다.
Step 5. 큰 candidate pool을 싸게 score한다
논문은 iteration마다 전체 50,000개 candidate pool의 $h$를 계산하고 상위 10%로 $\widehat{\mathcal{F}}_t$를 만든다.
Step 6. Mapper를 주기적으로 갱신한다
3 iteration마다 cover → DBSCAN → graph를 수행하고 region, centroid, $\hat\beta_0$, $\epsilon^{\ast}$를 cache한다.
Step 7. Global + centroid-local 후보를 만든다
전체 공간을 놓치지 않는 LHS와 각 region을 정밀 탐색하는 local perturbation을 함께 둔다.
Step 8. 후보를 topological role로 분류한다
bridge/frontier에는 $\Delta\beta_0=1$, interior에는 0을 부여하고 region visit count를 연결한다.
Step 9. TAL을 최대화한 한 점만 SPICE로 확인한다
측정된 성능을 dataset에 추가하고 topology가 바뀌었는지 확인한다.
Step 10. Feasible이면 멈추고, sign-off는 별도로 한다
모든 search constraint를 만족하면 early stop한다. 그 뒤 extracted layout, PVT corner, Monte Carlo mismatch, aging와 reliability 조건은 별도의 verification 단계로 넘긴다.
initial_data = SPICE(LHS(design_space, min(3*d, 50)))

while simulation_budget_remains:
    fit one probabilistic surrogate per specification
    score the 50,000-point candidate pool with h(x)

    every 3 iterations:
        near_feasible = top 10% by h(x)
        mapper = cover(h) -> DBSCAN -> graph components
        classify bridge / frontier / interior
        reset visits if beta_0 changed

    candidates = global LHS + local samples around region centroids
    next_x = argmax(region_discount * wEI + topology_bonus)
    observation = SPICE(next_x)
    update data and region visit count

    if every specification passes:
        return first feasible design
논문 설정은 좋은 reproducible starting point지만, 새 회로에서는 candidate pool 크기, GP calibration, Mapper stability, region별 실제 feasibility를 validation set과 seed sweep으로 다시 확인해야 한다.
8. 논문 실험에서는 얼마나 효과가 있었나?
논문은 두 open-source PDK의 네 회로를 사용했다.
| Circuit | Process | 설계 변수 수 | 대표 search 대상 |
| Two-stage amplifier(TSA) | GF180MCU | 7 | transistor widths, compensation capacitor |
| Cascode Miller-compensated amplifier(CMA) | GF180MCU | 10 | PMOS/NMOS widths, capacitors |
| Comparator | GF180MCU | 6 | PMOS/NMOS widths |
| LDO | SKY130 | 17 | widths/lengths, multiplicity, bias, resistor, capacitors |
각 method는 회로별 10개 specification target에서 최대 500회 SPICE budget을 받았다. baseline은 WEIBO, TuRBO, CMA-ES, Random Search, MACE, SCBO, PPAAS다. 성공 지표는 budget 안에 모든 사양을 만족한 run의 비율이고, FSD는 성공한 run에서만 첫 feasible design까지 걸린 simulation 수를 평균한 값이다.
ATLAS와 7개 baseline의 네 회로 success rate 및 ATLAS FSD
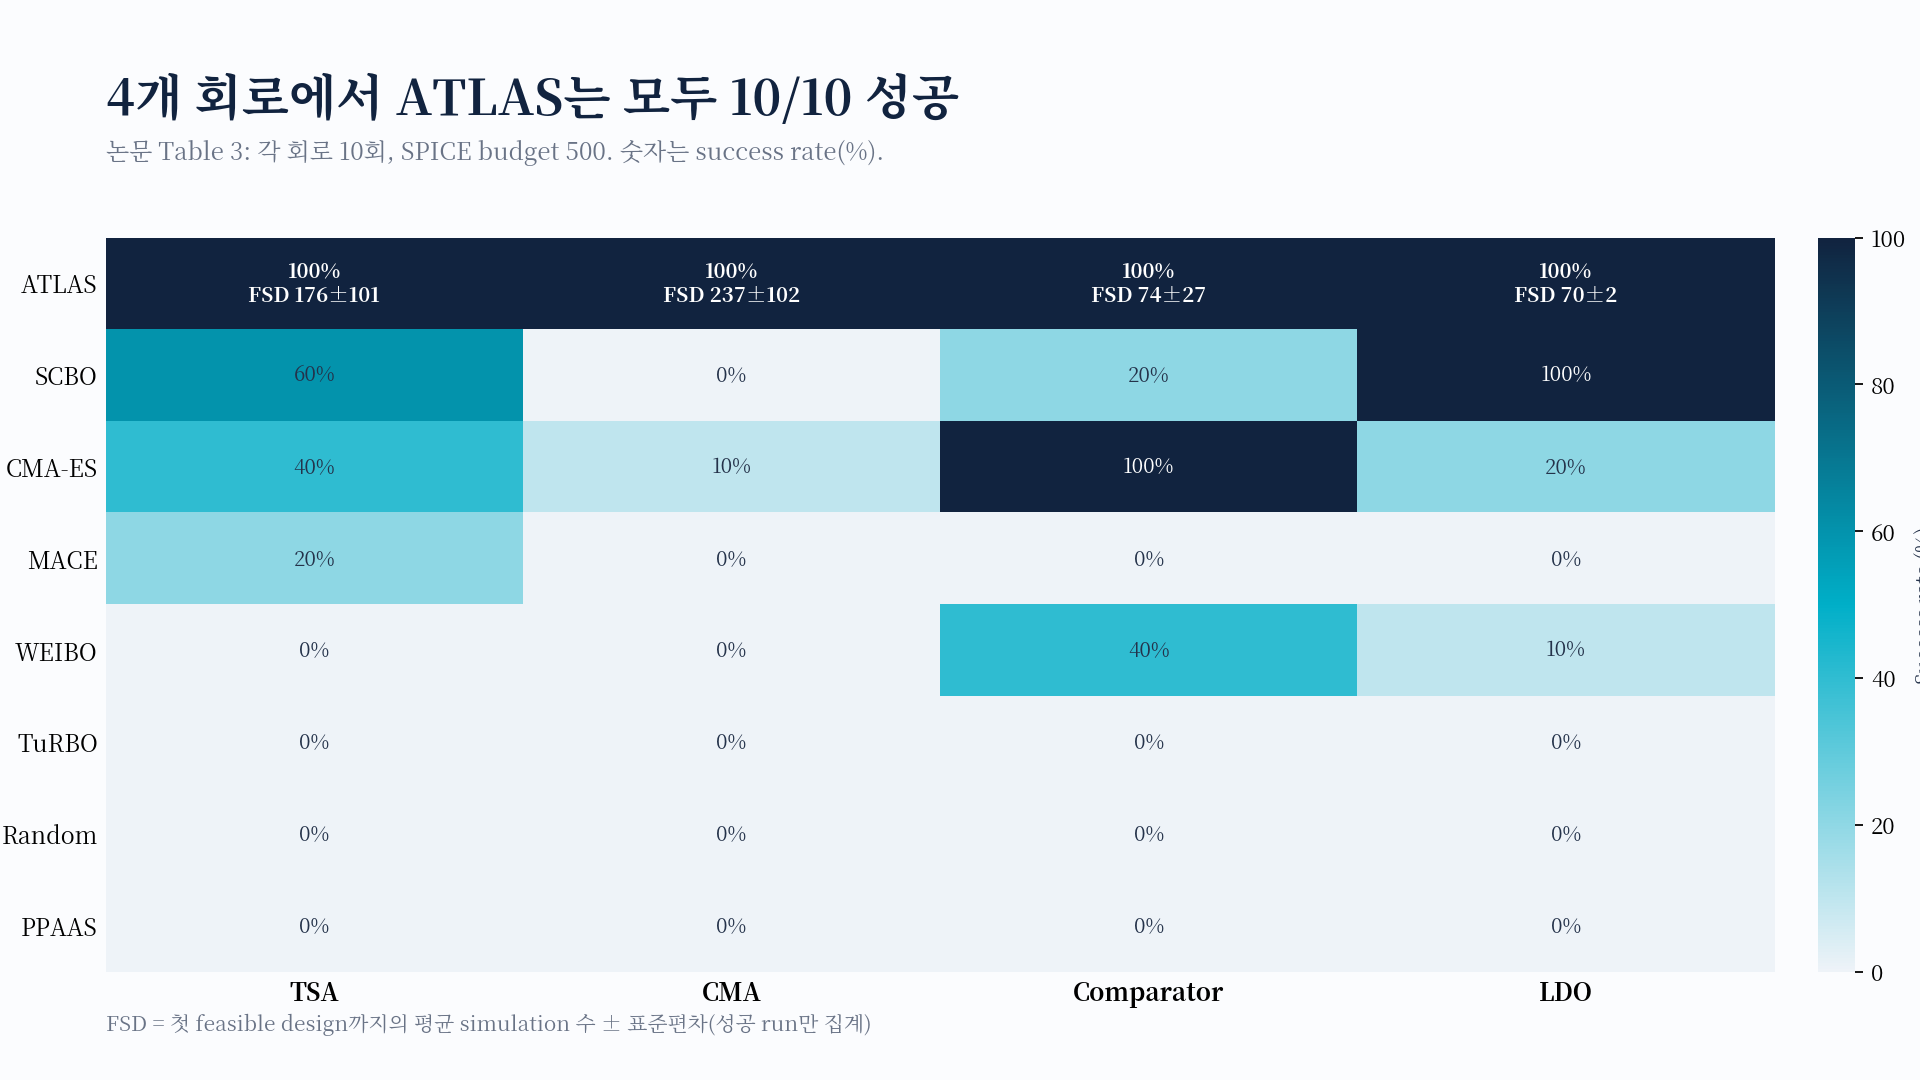
| Circuit | ATLAS | 가장 강한 비교 결과 | 읽을 때의 핵심 |
| TSA | 10/10, FSD $176\pm101$ | SCBO 6/10, $217\pm148$ | ATLAS만 모든 target 성공 |
| CMA | 10/10, FSD $237\pm102$ | CMA-ES 1/10, 464 | 나머지 6개 baseline은 0/10 |
| Comparator | 10/10, FSD $74\pm27$ | CMA-ES 10/10, $165\pm62$ | 같은 100% SR에서 ATLAS가 약 2.2배 빠름 |
| LDO | 10/10, FSD $70\pm2$ | SCBO 10/10, $164\pm86$ | 같은 100% SR에서 ATLAS가 약 2.3배 빠름 |
특히 CMA는 10개 변수와 6개 tightly coupled specification을 가진 가장 어려운 benchmark였다. 논문 보고에서 Mapper의 region 수는 iteration 50의 57개에서 iteration 160의 147개로 늘었다가, iteration 270에 25개, iteration 314에 13개로 줄었다. 첫 success는 iteration 330이었다.
CMA에서 보고된 Mapper region 수의 변화에 대한 개념 재구성
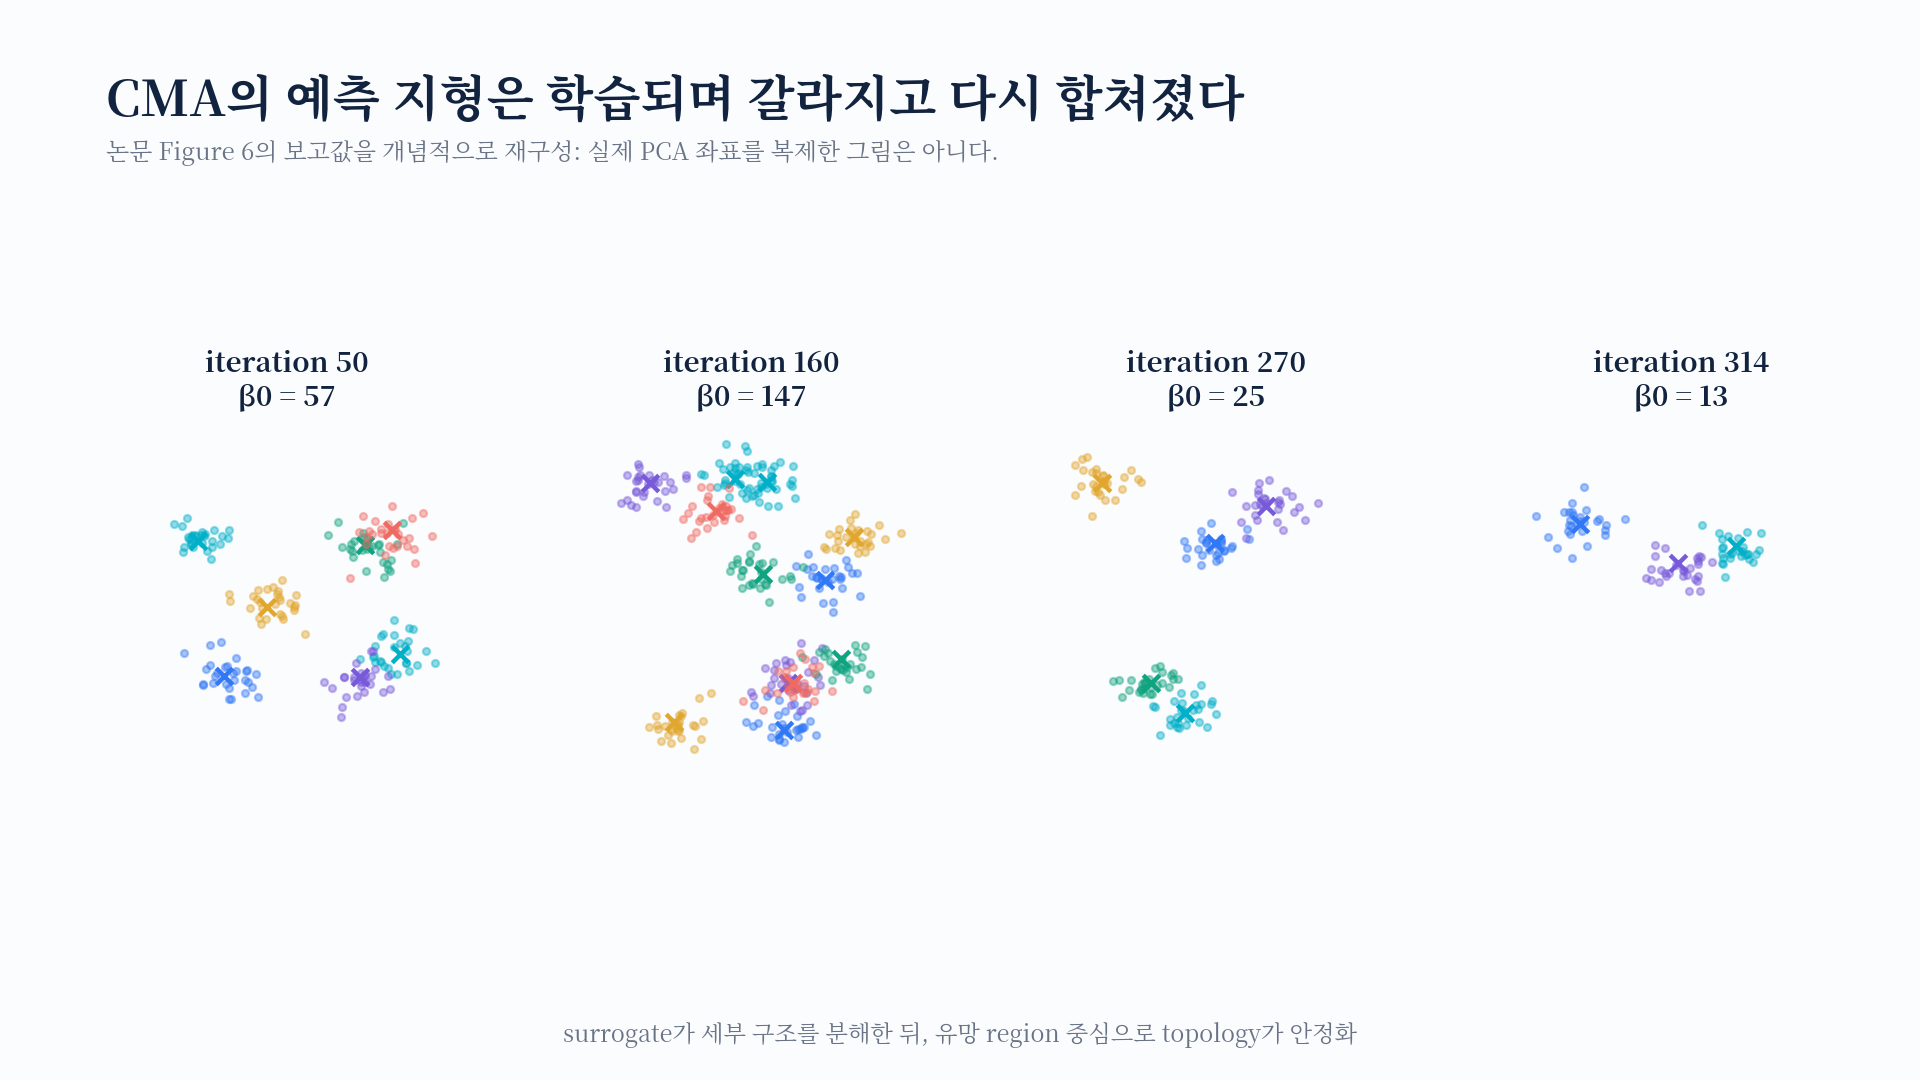
이 궤적은 “진짜 feasible set에 정확히 147개 component가 있다”는 뜻이 아니다. sparse observation에서 시작한 surrogate가 세부 구조를 나누고, query가 쌓이면서 유망 region 중심으로 예측 지형을 수정한 과정이다.
구성요소를 빼면 어떻게 됐나?
TSA ablation에서 ATLAS 구성요소를 하나씩 제거했을 때의 success run 수
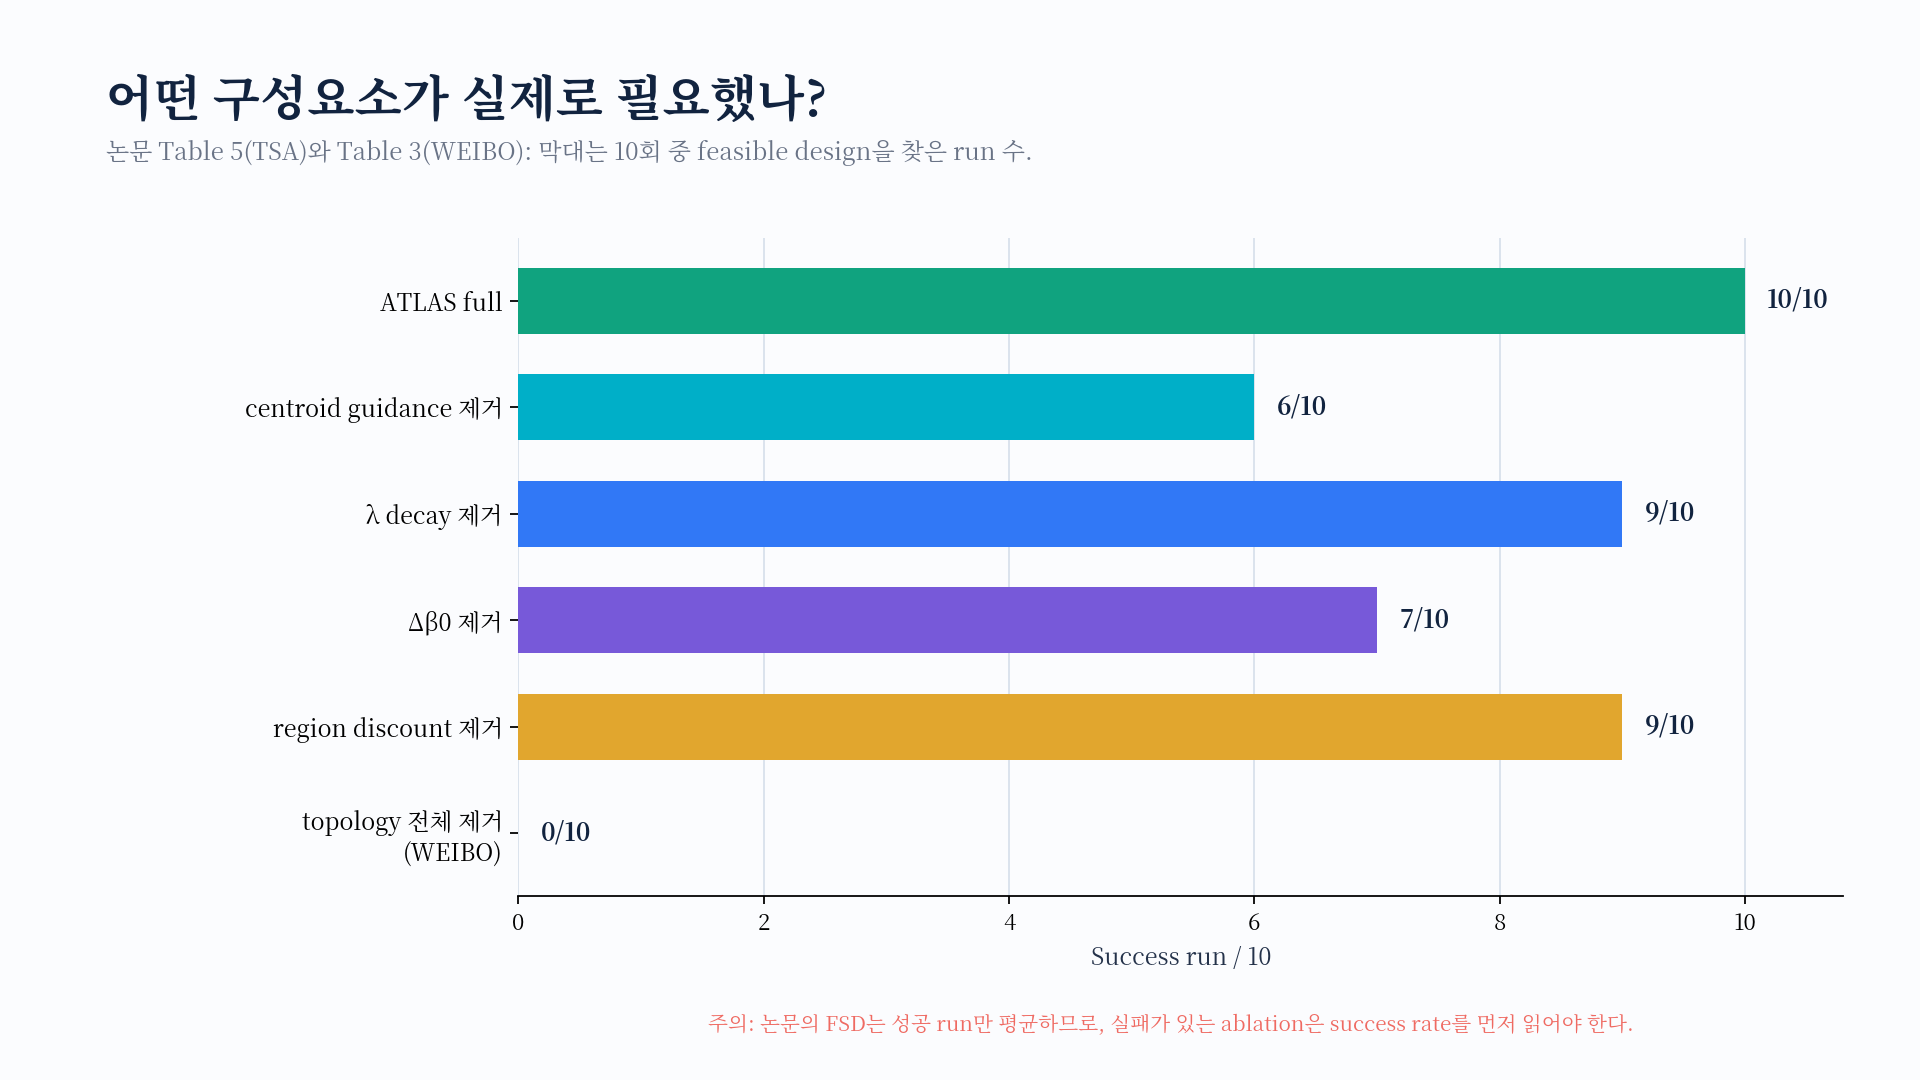
TSA ablation에서 full ATLAS는 10/10이었다. centroid guidance를 제거하면 6/10, $\lambda$ decay를 제거하면 9/10, $\Delta\beta_0$를 제거하면 7/10, region discount를 제거하면 9/10이었다. topology를 모두 끈 WEIBO는 같은 TSA 설정에서 0/10이었다.
여기서 FSD만 보고 “region discount 제거가 더 빠르다”고 결론 내리면 안 된다. FSD는 성공 run만 평균하므로 실패한 run이 censoring된다. 이 실험에서 ablation의 주된 분리 지표는 속도보다 success rate다.
TDA 계산은 얼마나 무거웠나?
논문의 open-source ngspice netlist 실험에서 Mapper construction 자체는 iteration당 0.01–0.04초였고 전체 iteration 시간의 2% 미만이었다. region assignment와 acquisition까지 포함한 controlled overhead는 WEIBO 대비 약 1–17%였다.
다만 이 wall-clock 수치는 extracted-layout simulation이나 industrial sign-off가 아니라 논문의 open-source benchmark 환경에 해당한다. industrial SPICE가 더 느리면 TDA의 상대 비중은 더 작아질 수 있지만, 그 추정은 해당 환경에서 다시 측정해야 한다.
9. 이 결과가 말하지 않는 것
새 방법을 실제 flow에 넣기 전에는 success headline보다 경계를 먼저 읽는 편이 안전하다.
1) “TDA가 실제 feasible topology를 복원했다”는 증명이 아니다
Mapper는 GP가 예측한 top-$\kappa$ point cloud를 분석한다. surrogate가 틀리면 region도 틀린다. 이 map은 query allocation을 돕는 adaptive heuristic이지, 물리적 feasible set의 certified reconstruction이 아니다.
2) Persistent homology 전체를 활용한 방법은 아니다
ATLAS가 직접 사용하는 핵심 정보는 Mapper graph의 connected component, 즉 $\beta_0$다. loop $\beta_1$이나 cavity $\beta_2$를 acquisition에 넣은 방법으로 소개하면 범위를 넓히는 셈이다.
3) PVT·mismatch·post-layout sign-off 결과가 아니다
논문은 GF180MCU와 SKY130의 open-source netlist benchmark에서 ngspice를 사용했다. conclusion도 process-corner topology를 future work로 남긴다. 따라서 “PVT robust sizing을 해결했다”거나 “tape-out ready design을 보장한다”고 말할 수 없다.
4) Pareto optimum이나 yield optimum을 찾는 목적이 아니다
실험 목표는 모든 constraint를 만족하는 첫 설계를 찾는 것이다. feasible 안에서 power를 더 낮추거나, PPA Pareto front를 넓히거나, rare-event yield를 certification하는 문제는 별도 objective와 검증이 필요하다.
5) 사양 간 posterior correlation을 직접 모델링하지 않는다
논문은 specification별 독립 GP를 fit하고 joint feasibility를 marginal probability의 곱으로 계산한다. gain·bandwidth·phase margin처럼 강하게 결합된 출력의 posterior correlation을 명시적으로 학습하는 multi-output GP는 아니다.
6) 네 회로의 10-run 결과를 모든 회로로 일반화할 수는 없다
논문 안에서는 ATLAS가 모든 benchmark에서 10/10을 달성했지만, topology, PDK, dimension, constraint tightness가 달라지면 결과도 달라질 수 있다. 저자들이 주장하는 “analog circuit automation에 TDA를 적용한 첫 연구” 역시 논문 저자의 조사에 따른 claim으로 읽어야 한다.
10. 어떤 상황에서 TDA-guided sizing을 먼저 시도할까?
잘 맞을 가능성이 큰 경우
- 여러 사양을 동시에 만족시키는 영역이 희소하고 multimodal하다고 의심될 때
- 기존 BO가 seed마다 서로 다른 region에 갇히거나 특정 사양 하나를 끝내 넘지 못할 때
- SPICE 한 번이 비싸서 population-based search의 수천 query를 감당하기 어려울 때
- surrogate candidate scoring은 싸고, 한 iteration에 수만 점을 평가할 수 있을 때
- “좋은 점 하나”뿐 아니라 서로 다른 operating regime의 후보를 함께 보존하고 싶을 때
먼저 단순한 방법을 검토할 경우
- feasible region이 넓고 거의 연결되어 standard constrained BO가 안정적으로 성공할 때
- simulation이 매우 싸서 random/evolutionary search의 sample cost가 문제가 아닐 때
- 초기 data가 너무 적거나 discontinuity가 심해 uncertainty calibration이 전혀 되지 않을 때
- 최종 목표가 첫 feasible point가 아니라 post-layout yield나 Pareto front 자체일 때
현실적인 도입 방법은 기존 BO를 한 번에 교체하는 것이 아니다. 동일한 initial design과 SPICE budget에서 다음 세 단계를 비교하면 된다.
- 기존 wEI 또는 constrained BO
- region discount만 추가한 버전
- Mapper classification과 centroid generation까지 포함한 full ATLAS
그리고 success rate, first-success simulation count, seed별 failure mode, region별 실제 feasibility, surrogate calibration을 함께 기록한다. 이 비교가 있어야 TDA가 예쁜 그림을 만든 것인지, 실제로 query budget을 바꾼 것인지 구분할 수 있다.
마치며: 회로 최적화의 질문을 ’점’에서 ’지형’으로
기존 BO는 “다음으로 가장 유망한 점은 어디인가?”를 묻는다. ATLAS는 그 앞에 질문 하나를 더 붙인다.
“지금 우리가 보고 있는 유망한 영역은 몇 개이며, 그중 어디를 아직 보지 않았는가?”
TDA가 SPICE를 더 정확하게 만들거나 회로 지식을 대신하는 것은 아니다. 대신 limited simulation budget을 한 predicted island에 모두 걸지 않도록, surrogate가 그린 설계 공간을 연결 region의 지도로 바꾼다. 이 작은 관점 전환이 ATLAS 실험에서는 네 회로 모두의 feasibility search를 안정화했다.
다음 단계는 분명하다. process corner별 landscape, post-layout parasitic, mismatch와 aging까지 포함할 때 region map이 얼마나 안정적인지 확인해야 한다. 그 검증을 통과한다면 TDA는 회로 최적화에서 분석용 시각화가 아니라 탐색 budget을 배치하는 control signal이 될 수 있다.
참고 자료
- Youngmin Oh, Jihwan Won, Yuntae Park, Bosun Hwang, and Suwan Kim, “ATLAS: Adaptive TDA-guided Landscape-Aware Transistor Sizing,” ICCAD 2026, 9 pages. DOI
- Gurjeet Singh, Facundo Mémoli, and Gunnar Carlsson, “Topological Methods for the Analysis of High Dimensional Data Sets and 3D Object Recognition,” Eurographics Symposium on Point-Based Graphics, 2007. DOI
- Wenlong Lyu et al., “An Efficient Bayesian Optimization Approach for Automated Optimization of Analog Circuits,” IEEE TCAS-I, 2018. DOI
- David Eriksson and Matthias Poloczek, “Scalable Constrained Bayesian Optimization,” AISTATS 2021. PMLR
출처와 그림 안내: 본문 수식·알고리즘·실험 수치는 제공된
2026_ICCAD_BO_TDA (1).pdf의 Sections 3–5와 Tables 1–6을 바탕으로 정리했다. 표지 이미지는 이 글을 위해 생성했으며, 나머지 기술 도식은 논문 내용을 바탕으로 새로 그렸다. 원 논문의 figure를 복제하지 않았다.07-cma-topology-evolution.png는 논문에 보고된 iteration별 $\hat\beta_0$ 값의 개념 재구성이며 실제 PCA 좌표가 아니다.